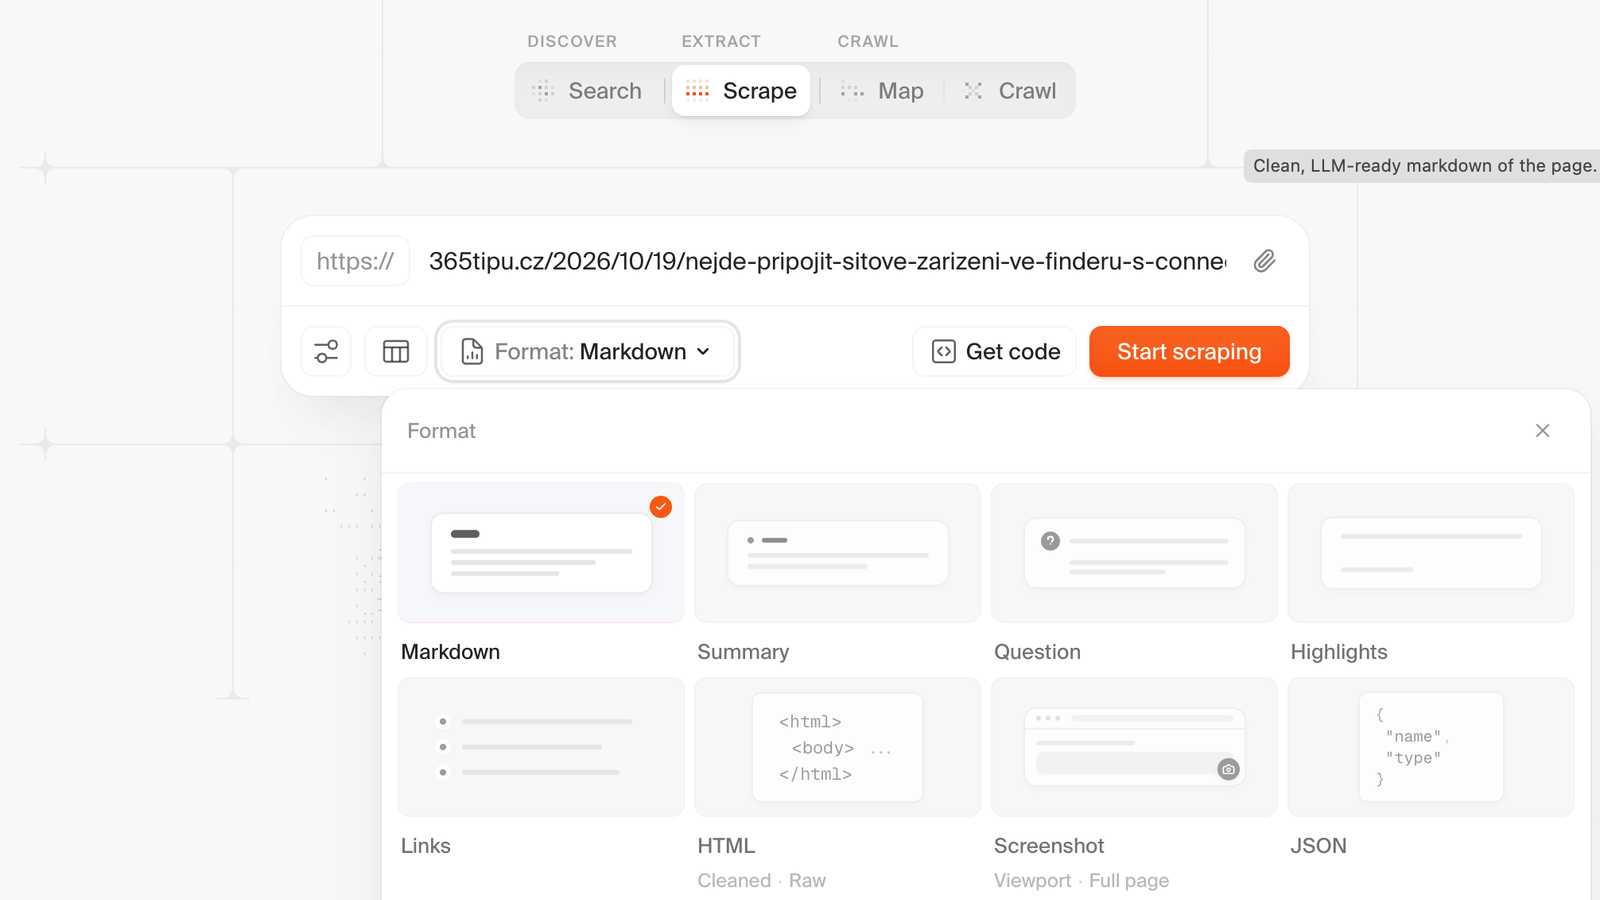
Firecrawl vezme webovou stránku a připraví její obsah pro další nástroj. Místo aby AI agent dostal hromadu HTML, navigačních nabídek a patiček, může dostat čistší text v Markdownu nebo data ve formátu JSON. Hodí se hlavně tehdy, když se to má opakovat nebo automatizovat. Pokud potřebujete jen jednou přečíst jeden článek, je to nejspíš zbytečně velké řešení.
A nepotřebujete k tomu hned vlastního AI agenta. Firecrawl lze vyzkoušet přes webový Playground, příkazovou řádku nebo API. Vlastní automatizace přijde na řadu až tehdy, když chcete zpracovávat více stránek opakovaně.
Konkrétní příklad vztahu mezi agentem a Firecrawl je Hermes Agent, open-source agent od Nous Research. Firecrawl v něm slouží jako výchozí webový backend: Hermes se o webové hledání a načítání obsahu opírá o Firecrawl, který mu připraví podklady pro další práci. Podrobnosti popisuje integrace Firecrawl s Hermesem; praktický příklad agenta najdete také v tipu AI Agent Hermes a výběr cíle výletu.
Proč neposlat AI rovnou webovou stránku?
Webová stránka není vždy připravená jako čistý text. Někdy se její obsah načítá až pomocí JavaScriptu, jindy je hlavní text utopený v navigaci, reklamách a dalších prvcích. Když se všechno pošle do jazykového modelu, zbytečně se zpracovává i balast.
Firecrawl se snaží obsah stránky získat a převést do podoby, která se pro další zpracování hodí lépe. Není to ale kouzelné tlačítko na celý internet: některé stránky nemusí jít načíst, výsledek může být neúplný a samotný převod nezaručuje, že AI správně pochopí obsah.
Podobný problém řeší i starší tip o získání čistého obsahu z URL pomocí Pythonu. Firecrawl k tomu přidává službu, rozhraní pro automatizaci a práci s více stránkami.
Jedna stránka, hledání i celý web
Základní funkce se jmenuje Scrape: zadáte adresu jedné stránky a Firecrawl vrátí její obsah, například jako Markdown nebo HTML. Pro strukturovanější výstup lze použít JSON, pokud chcete z webu získat konkrétní pole. Podrobnosti a podporované formáty popisuje dokumentace Scrape.
Když ještě nevíte, které stránky potřebujete, Search hledá obsah na webu. Map pomáhá zjistit, jaké stránky daný web obsahuje. Crawl projde více stránek a stáhne jejich obsah. Interact umožňuje pracovat se stránkou přes prohlížeč, například provést akci nebo se dostat k obsahu, který vyžaduje interakci. Popisy funkcí jsou v dokumentaci pro Search, Map, Crawl a Interact.
Praktický rozdíl: Scrape použijete na jednu známou URL, Crawl na větší část webu a Map na zjištění, co stojí za to procházet. U rozsáhlejšího webu si hlídejte rozsah crawlů, protože každá další stránka znamená další práci a může znamenat i další spotřebu kreditů.
Kolik Firecrawl stojí?
Firecrawl používá kreditové plány. V dokumentaci je uveden bezplatný přístup s 1 000 kredity měsíčně; u placených plánů se kredity i cena liší podle tarifu. Zachycené podklady potvrzují například 5 000 kreditů pro Hobby a 1 000 000 pro Scale. Aktuální rozpis je na ceníku Firecrawl a pravidla čerpání v billing dokumentaci.
Při automatickém dobíjení se mohou kredity přikoupit v přírůstcích po 5 USD. Lze nastavit i měsíční limit dobíjení. To je užitečné, když automatizace běží bez dozoru, ale dobíjení je potřeba vědomě zapnout a zkontrolovat, jinak hrozí překvapení na faktuře.
Před volbou tarifu si ověřte aktuální cenu i to, kolik kreditů spotřebuje právě vaše kombinace funkcí. Scrape jedné stránky, hledání a získávání strukturovaných dat nemusí mít stejnou cenu. Neberte proto starší cenu z článku nebo diskuse jako platnou nabídku.
Pro první pokus lze využít omezené příkazy bez přihlášení, které mají limit podle IP adresy. S bezplatným API klíčem Firecrawl uvádí vyšší limit a 1 000 kreditů. Dokumentace CLI popisuje přihlášení i bezklíčový režim.
Jak vypadá jedno volání API
Firecrawl má REST API v2. Pošlete URL, zvolíte formát a přidáte API klíč jako Bearer token. Ukázka stáhne obsah jedné stránky do Markdownu:
curl -X POST 'https://api.firecrawl.dev/v2/scrape' \
  -H 'Authorization: Bearer [REDACTED]' \
  -H 'Content-Type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"]}'
Zástupný text [REDACTED] nahraďte svým klíčem a nikam ho veřejně nevkládejte. Podle stejného principu lze použít oficiální SDK nebo CLI. Pro připojení k AI nástrojům existuje také MCP server Firecrawl, ale běžný uživatel nemusí MCP ani agenta vůbec řešit.
Kdy Firecrawl dává smysl a kdy ne
Firecrawl dává smysl, když pravidelně sbíráte obsah z více stránek, stavíte nad ním automatizaci nebo potřebujete, aby ho následně zpracoval další program či AI. Hodí se i tehdy, když nechcete sami skládat několik samostatných kroků: načtení stránky, odstranění balastu, převod formátu a procházení odkazů.
Pro jednorázové přečtení článku je to nejspíš zbytečné. Pokud chcete jen občas dostat čistý text z jedné URL, zkuste nejdřív nástroj, který už máte, nebo vlastní jednoduchý skript. Jestli chcete provozovat vlastní extrakční řešení, Crawl4AI je jedna z alternativ. Skládačka z Playwrightu a Trafilatury dává smysl spíš technicky zdatnějším, kteří chtějí mít jednotlivé části pod kontrolou a nevadí jim je udržovat.
Firecrawl lze spustit také na vlastním serveru pomocí Docker Compose. Není to ale totéž co zaplatit cloudovou službu a dostat stejné provozní podmínky. U self-hostingu si sami řešíte aktualizace, zabezpečení, úložiště, monitoring a obnovu. Dokumentace zároveň upozorňuje, že lokální instalace nemusí podporovat všechny možnosti Firecrawl Cloud. Návod k self-hostingu proto nejdřív projít a zvážit, jestli se vám vlastní provoz vůbec vyplatí.
Na co si dát pozor
Nejdražší chyba bývá nechat automatizaci bez limitu a zjistit až zpětně, kolik stránek zpracovala. Udržujte si přehled o spotřebě, nastavte měsíční limit dobíjení, pokud ho využíváte, a pro oddělené projekty používejte samostatné API klíče. Konkrétní možnosti limitů a přehledu spotřeby si ověřte v aktuální billing dokumentaci a dokumentaci rate limits.
U crawlů si nejdřív rozmyslete, kolik stránek skutečně potřebujete. Nezačínejte celým webem, pokud vám stačí pár adres. A pokud stránka vrátí chybu, blokuje automatizované načtení nebo mění obsah podle přihlášení, nespoléhejte na to, že Firecrawl ji určitě obejde.
Firecrawl není nutné nasazovat jen proto, že používáte AI. Nejprve si ujasněte, co chcete z webu získat a jak často. Pro jednu stránku bývá lepší jednoduchý nástroj; pro opakované stahování a automatizaci může být Firecrawl pohodlnější, pokud vám jeho kreditový model vychází.
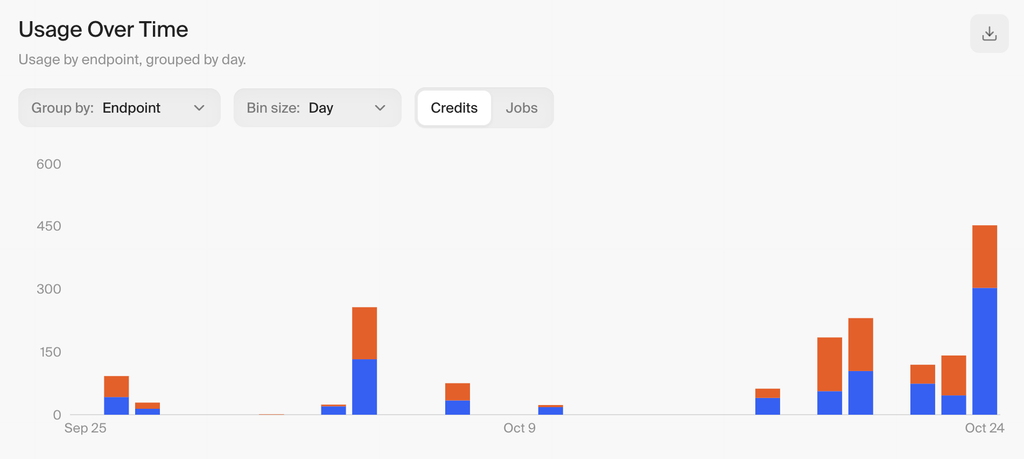
POZNÁMKA: Výše je komplet Hermes Bot, tady Skill pro 365tipů. První snaha selhala, strašně slouho něco pořád hledal, až narazila na strop. Po aktualizac Skillu selhal opět, navíc ten skill poněkud začal ignorovat. Sešlo se v tom pár chyb, trochu mezi židlí a klávesnici. Můj Hermes měl malé kontextové okno a velká zadání vedla k opakované komprimaci a ztrátě toho co už dělal. A druhá, pro tohle jsem si od Claude nechal připravit vlastně už slušný research a Hermes to celé. bod po bodu, zkoušel ověřovat. Ač vlastně nemusel.
Ve finále na to padlo 3.60 Kč na první selhání a 5.83 na druhý pokus, který jsem ale ručně zastavil. Poučení je samozřejmě ještě jedno, nemůžete to nechat běžet jen tak, musíte to hlídat. A nastavit i nějaké limity na všechno co vlastně „může“ chtít dělat.
Další tipy týkající se AI (ChatGPT a další)