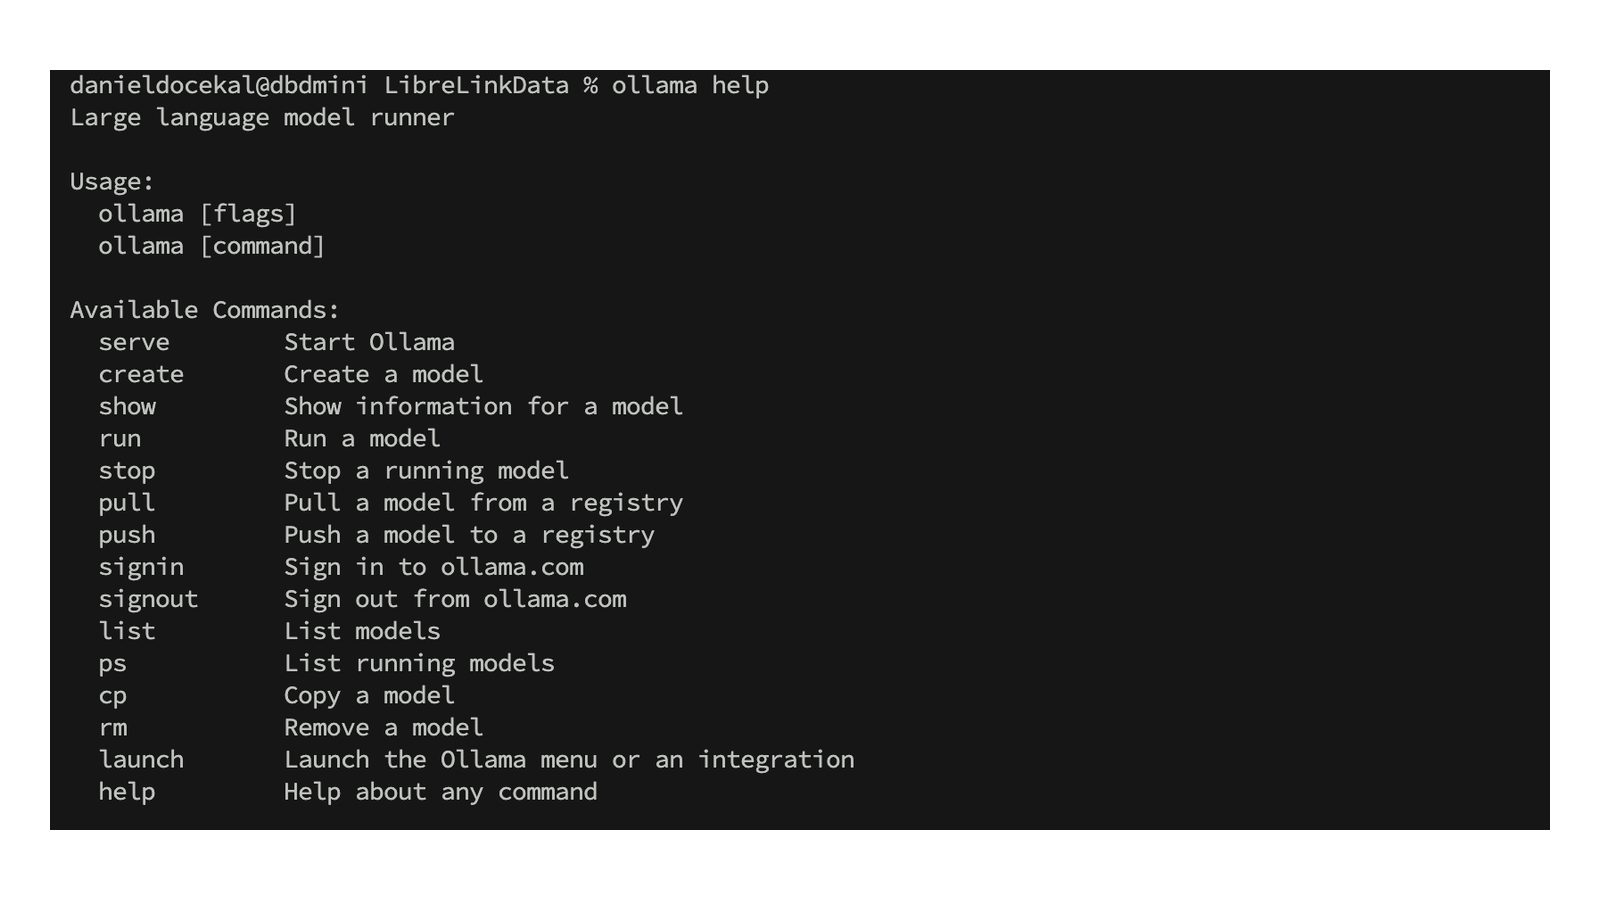
S pomocí Ollama si můžete snadno do Mac OS pořídit lokální AI modely. Instalace je probraná v samostatné tipy, ale podstatná “maličkost” bude, s jakým modelem budete chtít pracovat.
Je to totiž důležité pro rychlost, kvalitu, s ohledem na dostupnou paměť. A navíc Ollama umí (a má) modely, co dokáží lépe využít Apple Intelligence.
Modelů v Ollama můžete mít nainstalovaných víc a podle potřeby je volat. Některé jednodušší a rychlejší stačí na základní věci, některé pokročilejší a náročnější ale možná budete potřebovat pro komplexnější záležitosti.
Čím můžete začít
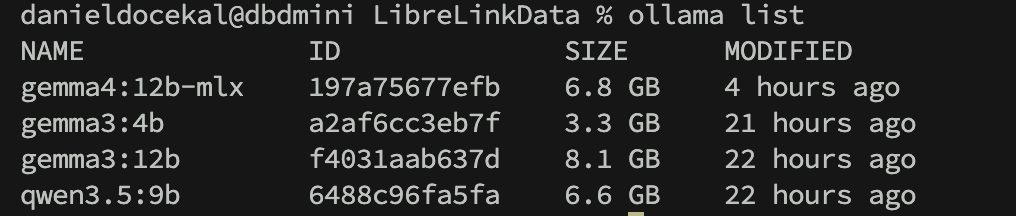
qwen3.5:9b – ollama pull qwen3.5:9b – střední rychlost, menší nárok na paměť, ale možná (no, spíš určitě) bude čeština problém, ale je přemýšlivý, takže i v tom pozor. V přemýšlivé podobě umí být extrémně pomalý.
mistral-small:24b – ollama pull mistral-small:24b – bude pomalejší, ale vejde se. Zajímavé na něm je, že je to evropský model.
llama3.1:8b – ollama pull llama3.1:8b – pokud vám jde o rychlost, tak je to jedna z možných cest.
gemma3:12b – ollama pull gemma3:12b – pokud chcete model od Google, co je multimodální, do 24 GB Mac Mini se vejde, ale s ohledem na velikost bude pochopitelně pomalejší.
TIP: Lokální AI na Mac Mini (a lepších) s pomocí Ollama. Jak zprovoznit, krok po kroku
gemma3:4b – ollama pull gemma3:4b – menší model od Google, co bude rychlejší, ale také bude mít horší kvalitu výstupů.
POZNÁMKA: Multimodální znamená, že umí obrázky na vstupu, ale není to generování obrázků, to jsou jiné modely i jiné aplikace – Stable Diffusion, ComfyUI, Draw Things.
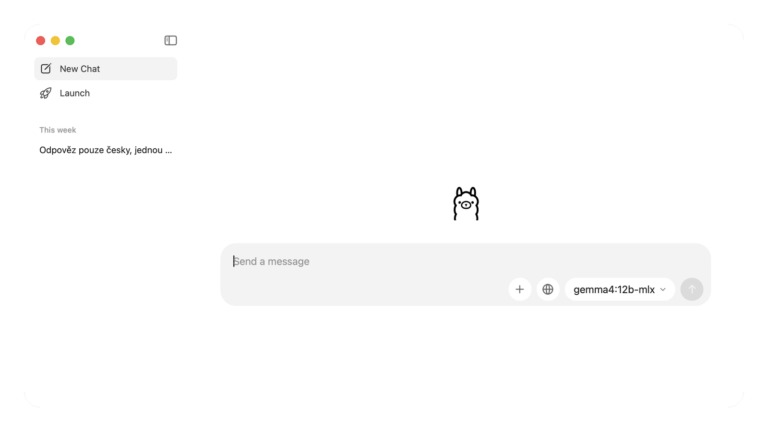
gemma4:12b-mlx – ollama pull gemma4:12b-mlx – MLX modely umí specificky využít Apple Silicon pro vyšší výkon, což značí ono mlx v názvu. A pozor, je “thinking”
qwen2.5-coder:7b – ollama pull qwen2.5-coder:7b – může se hodit pro Codex/Claude Code, je malý (a tím rychlejší) a určený pro kódování. V pohodě pro 16GB paměti. A má ještě větší podobu – qwen2.5-coder:14b
devstral-small-2 – ollama pull devstral-small-2 – další pro kódovánía, ale pro 32GB paměti a víc.
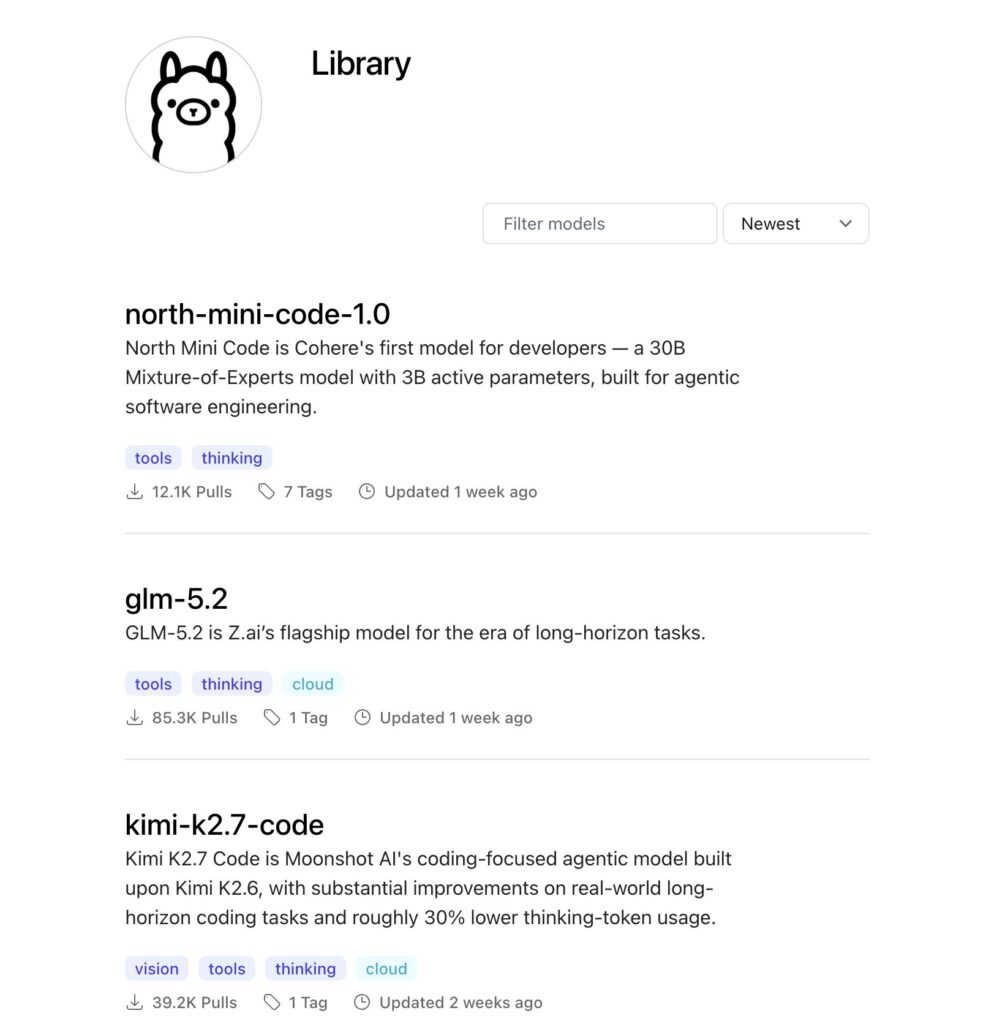
Modelů je každopádně mnohem více, přehled najdete v Ollama na webu a vedle lokálních jsou tam i cloudové – na širší využití těch cloudových ale musíte mít u Ollama účet a platit měsíční poplatky. Ostatně stejně jako když přistupujete k ChatGPT, Gemini či dalším cloudovým IA přímo.
MoE (Mixture of Experts modely)
Uvažovat můžete o MoE modelech, ale ty zpravidla bývají velké a v mém připádě se do 24 GB paměti spíš nevejdou. Ale i to je prostě potřeba otestovat. Takže třeba:
ollama pull gpt-oss:20b – MoE model od OpenAI. je dělaný pro lokální / nízkolatenční použití a díky kvantizaci MoE vah do MXFP4 má menší model běžet už na systémech s 16 GB paměti (video pamětí samozřejmě míněno, což i Mac prostě sežere velkou část unifikované paměti). Takže by fungovat mohl. Opět ale pozor, je přemýšlivý.
A případně si najít další.
Při testování pozor, Mac OS se chová při vyčerpání paměti zcela chaoticky a dokáže prostě natvrdo zhavarovat, včetně možného poškození disku.
Jak rychlé to bude?
Čistě prakticky, například první uvedený qwen3.5:9b bude pomalý, dokud nepotlačíte přemýšlení a v češtině dokáže tvořit vesmírně originální nesmysly. 24 GB unifikované paměti prostě není NVIDIA AI síla a navíc si musíte ohlídat, aby paměť nebyla zaplněná (Chrome je na to expert).
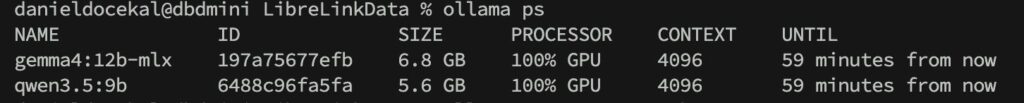
Rozdíl mezi během s hodně plnou pamětí a poloprázdnou je velký. Reálně ten model bude potřebovat pod 6 GB paměti. Použijte ollama ps a uvidíte (paměť, využití CPU, context), ale musí samozřejmě něco běžet.
Tady je důležité volit správné modely pro konkrétní úlohy. Podobně jako u cloudových, kde platíte za tokeny, volíte rychlejší/levnější vs. důkladnější/dražší, tak tady to budete řešit z pohledu rychlosti (tokeny vás nepálí).
POZNÁMKA: Pro představu podivnosti, co gemma3:4b dokázala vytvořit (z tohoto článku) :
Anthropic získala povolení k uvolnění Claude Mythos 5 pro více než 100 institucí, včetně Amazonu, po dvou týdnech blokování Trumpovým BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍDLOVÝM BŘÍD
Proto, například, pokud chcete mít k dispozici “CAPS LOCK REMOVER” (používám často a mám ho právě v MacAI předdefinovaný), tak bude bohatě stačit gemma3:4b – odpověď je takřka okamžitě. gemma3:12b odpovídá pomaleji. A jak funguje případně viz Jak text VELKÝMI PÍSMENY převést na správná malá a velká písmena? Jasně že přes ChatGPT
Pro představu, jak rychlé jednotlivé modely jsou :
| Model | Studený start | Zahřátý běh | Slov |
| gemma3:4b | 10,79 s | 4,34 s | 46 |
| gemma3:12b | 25,62 s | 11,83 s | 39 |
| gemma4:12b-mlx | 21,26 s | 6,29 s | 28 |
| qwen3.5:9b | 21,33 s | 10,62 s | 40 |
| OpenAI gpt-4o-mini | 1,20 s | 1,65 s | 29 |
Velký rozdíl mezi prvním a druhým lokálním během způsobuje načítání modelu do paměti Ollamy. Po zahřátí je poměr realističtější. Ollama drží model (modely) v paměti 5 minut, takže pokud ji budete volat méně často, je dobré využít keep_alive, aby tam zůstal delší dobu. Což je nutné přidat jako součást volání, nejde to nastavit natrvalo. Co je v paměti zjistíte klasicky pomocí “ollama ps”.
A pro MacMini je opravdu vhodné jít do mlx modelu. Nejen že (ve srovnání s 12b bez mlx) je skoro 2x rychlejší, ale vypadá to, že i vrací kvalitní výsledky v češtině. Rychlost po zahřátí není daleko od 4b modelu a podstatně delší první start jde řešit tím, že ji prostě necháte v paměti delší dobu.
Samozřejmě volání ChatGPT přes její API je mnohem rychlejší, ale zajímavé bude se ještě později podívat na to, jak poběží Ollama na Windows stroji s 16 GB RTX 5020 Ti.
TIP: Žebříček LLM – Srovnání více než 100 AI modelů od OpenAI, Google, DeepSeek a dalších. je dobré místo s informacemi o modelech, co se rychlosti/nároků týče. Hodit se může i Nezávislá analýza AI
Další tipy týkající se ChatGPT