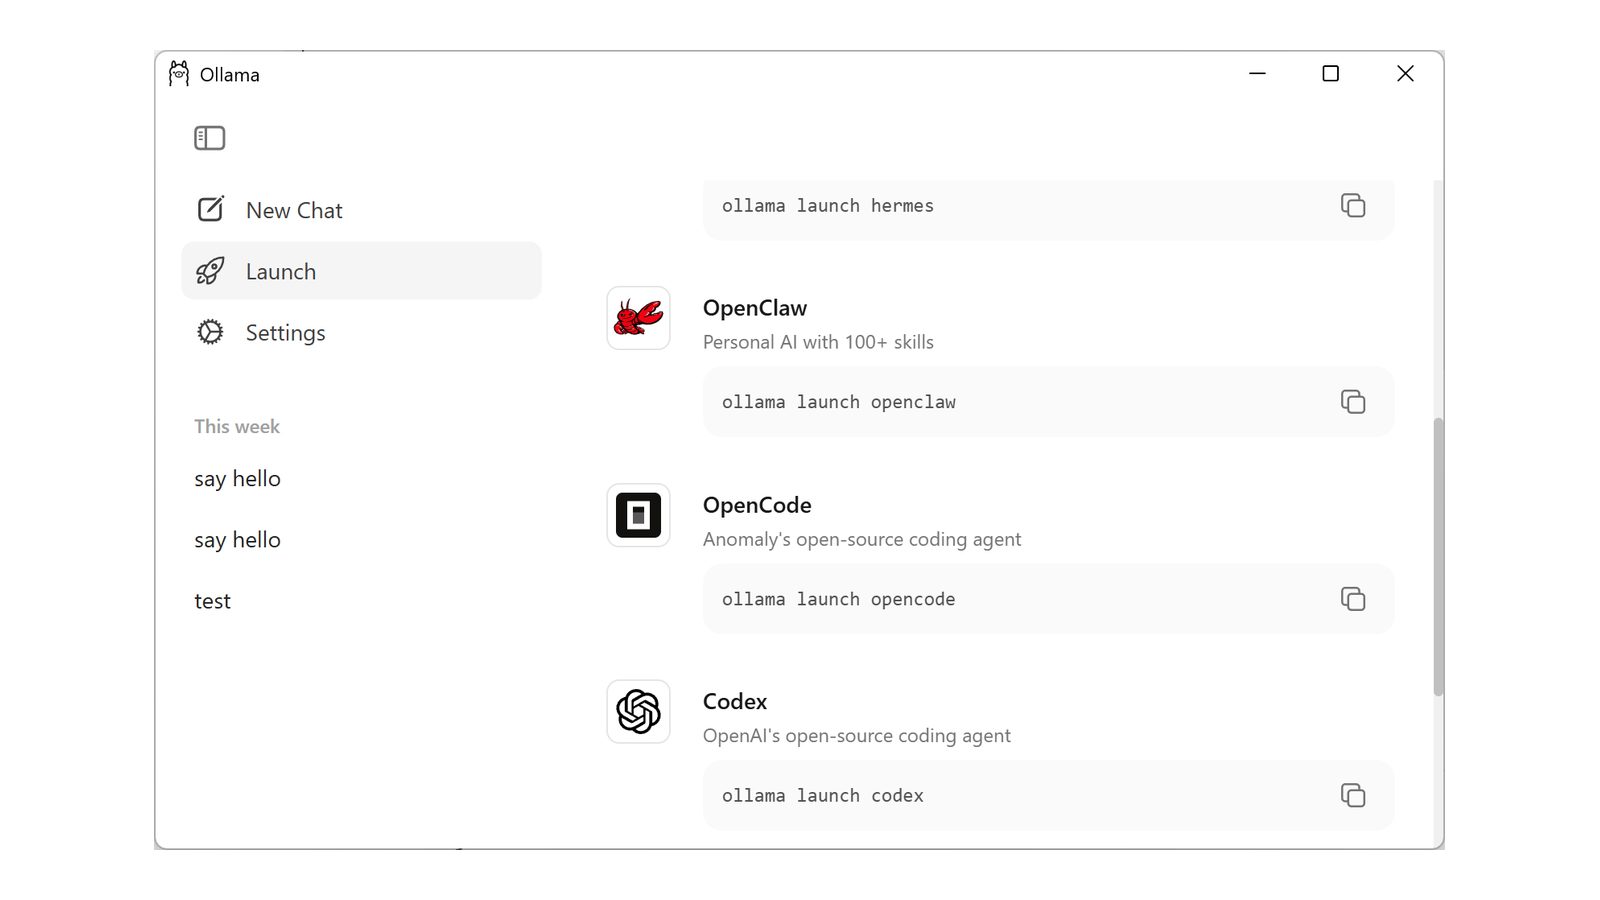
Především, nejspíš vám stažená Ollama neprojde přes aplikační ochranu, je nutné ji vypnout ve Windows Security a Smart App Control. Po instalaci můžete vrátit zpět. Případně instalovat třeba přes stažení ZIP archivu nebo “winget install Ollama.Ollama”
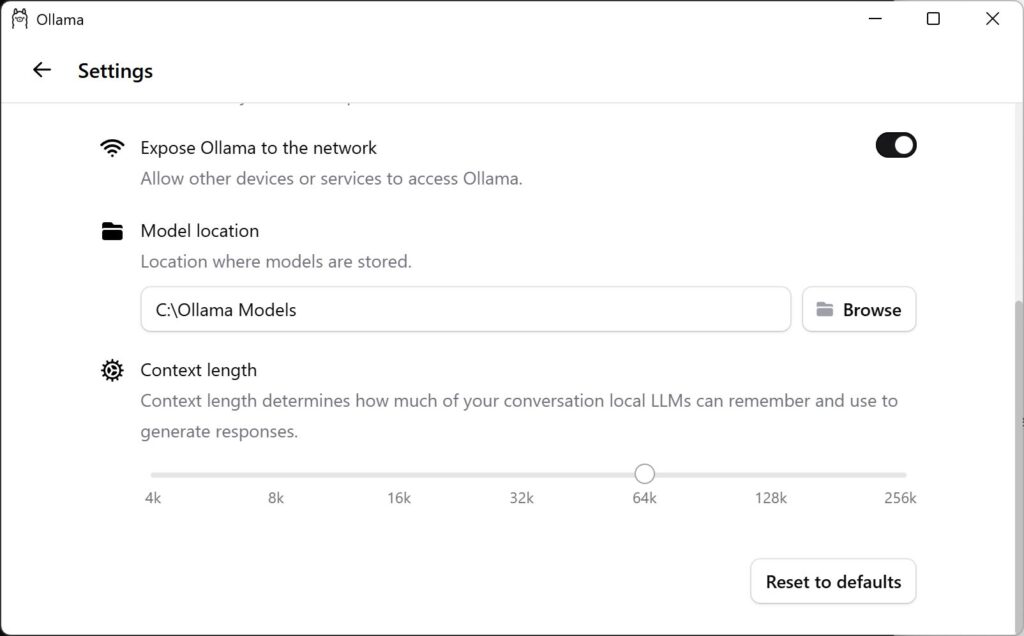
Je dobré si pro modely vytvořit extra složku, není důvod aby to bylo v hloubi vaší osobní složky. A tu pak nastavit v Model Location.
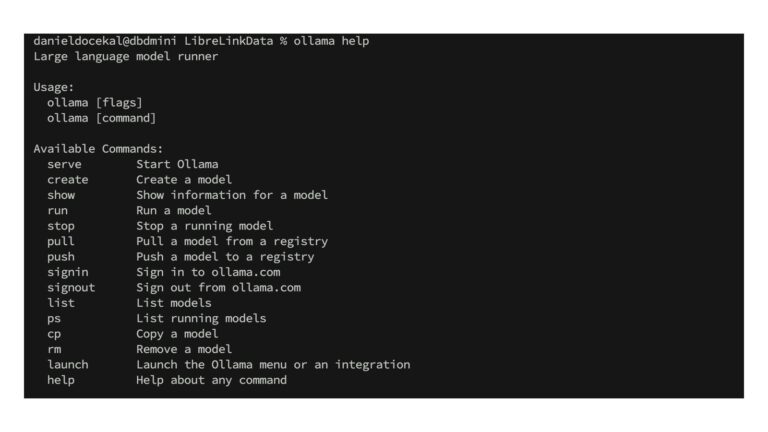
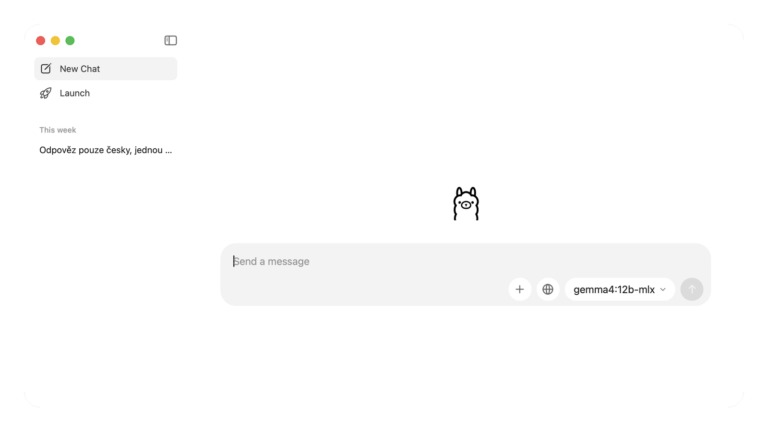
Ollama je k dispozici v liště pod obvyklou ikonou, a také v příkazové řádce jako “ollama”. Což v první fázi použijete pro stažení modelů a pak pro další ovládání.
V novém terminálu ve Windows 11 fungují i takové ty běžné věci jako ls či doplňování přes Tab, takže to můžete mít o kousek jednodušší.
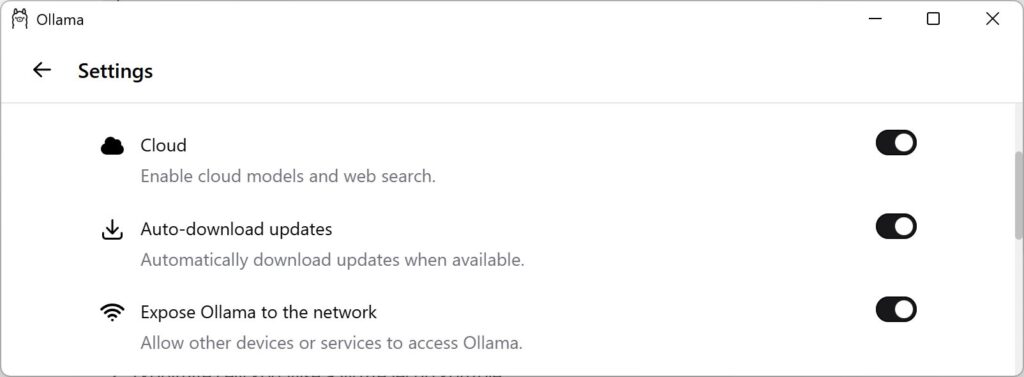
V Nastavení nezapomeňte aktivovat přístup přes síť, pokud chcete k WIndows stroji a jeho AI přistupovat odjinud.
Čistě prakticky, pokud už máte stažené modely jinde (jako třeba na MacMini) tak je můžete prostě zkopírovat na Windows (a opačně). Pro rozpoznání stačí restart ollama. Ušetříte si tak případné delší stahování.
Mimochodem i pro Windows existuje proměnná prostředí ohledně umístění modelů “OLLAMA_MODELS”, ale umístění je snazší zvolit v Nastavení aplikace.
TIP: Lokální AI na Mac Mini (a lepších) s pomocí Ollama. Jak zprovoznit, krok po kroku
Jak je to s rychlostí
Windows stroj má 16 GB NVIDIA a 48 GB RAM, zatímco Mac Mini je 24GB unifikované paměti. A samozřejmě je tu rozdíl architektur. A zde je srování modelů z macmini a na Windows – už včetně gpt-oss (ale pochopitelně na Windows nejde spustit MLX varianta):
| Model | Mac první běh | Windows první běh | Mac zahřátý | Windows zahřátý |
| gemma3:4b | 10,79 s | 3,57 s | 4,34 s | 0,75 s |
| gemma3:12b | 25,62 s | 5,26 s | 11,83 s | 1,37 s |
| qwen3.5:9b | 21,33 s | 18,59 s | 10,62 s | 1,46 s |
| gpt-oss:20b | 27,12 s | 5,86 s | 11,98 s | 1,95 s |
| gemma4:12b-mlx | 21,26 s | nedostupná | 6,29 s | nedostupná |
Závěr?
- Windows je po zahřátí přibližně 6–9× rychlejší.
- gemma3:12b je na Windows výborný kompromis: kvalitnější než 4b a jen 1,37 s.
- gpt-oss:20b zahřátý zvládá shrnutí za 1,95 s i zahřátí je rychlé.
- Qwen byl rychlý, ale vytvořil příliš dlouhé a jazykově slabší shrnutí.
I tady připomenu, že “zahřáti” je první nahrání modelu do paměti a vždy bude trvat delší dobu. Ollama ho pak v paměti nechá, ale jen pět minut, takže si to prodlužte. Osobně tam mám aktuálně 60 minut.
Ten test se týká práce s textem (načte se článek z URI a vytvoří se z něj shrnutí, ten jeden odstavec co se používá v newsletteru na 365tipech i #TYDEN). Jiné metody užití mohou mít jiné výsledky, ale když už nic, tak se aspoň pro všechny modely zkouší stejný test.
Aktuálně používám právě tu Gemma3:12b (v MLX podobě na Macu, v klasické na Windows). Je rozumně rychlá a nedělá tolik chyb jako 3b. Na Macu zabírá 8 GB, což je také rozumné (stroj má 24 GB paměti a musí se na něm dát dál pracovat).
Qwen3.5:9b je prakticky nepoužitelný – nejen že je vlastně stejně rychlý jako větší Gemma, ale nezvládá češtinu a hodně chybuje.
POZNÁMKA: Muj tosummary.py teď umí to, že se nejprve mrkne, jestli běží Ollama na Windows a použije ji. Pokud neběží tak použije tu na Mac Mini. Windows poskytne rychlost pokud bych ji potřeboval, ale není moc důvod ten stroj mít zapnutý pokaždé (fouká, hučí a hřeje, jak jinak). Pokud mi nevadí pár sekund na běh navíc, tak to Mac Mini zvládá.
Další tipy týkající se ChatGPT