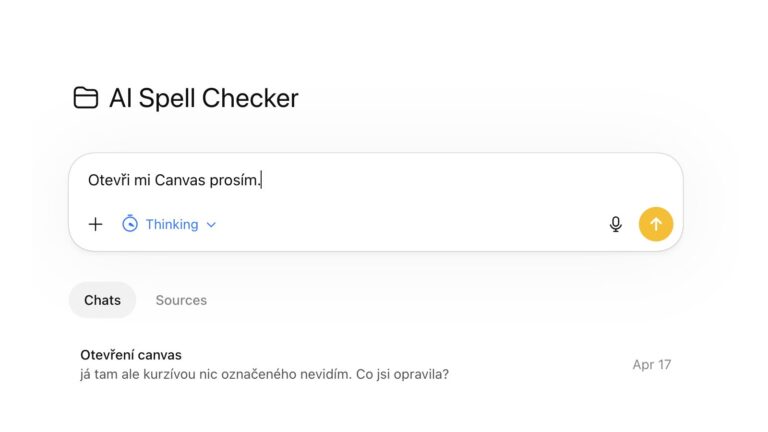
AI Spell Checker jsem si vytvořil už dřív. ChatGPT, doladěný prompt a cesta skrz Canvas, to aby šlo udělat copy – kontrola – paste a zůstalo zachované formátování.
Popsané je to v Jak využít ChatGPT pro kontrolu pravopisu? Jde to. Ale něco byste měli vědět a má to specifické užití i v tom, že v opraveném výsledku označuje, co bylo opravené. Abych to mohl zkontrolovat a použít/nepoužít.
Jenže třeba právě pro psaní věcí pro 365tipů nebo na osobní blog je tohle zbytečně komplikované. Takže vznikla další podoba, která se ukázala extrémně užitečná.
Funguje snadno
- Zkopírovat text do schránky. Formátovaný/HTML, s odkazy a vším
- Zmáčknout Shift+Ctrl+S a chvíli počkat, až pípne
- Ve schránce je opravený text se zachovaným formátováním a vším dalším
- Paste/Vložit na původní místo
Ona cesta přes schránku je užitečná v tom, že tohle je zcela univerzální. Navíc to už používám pro překlady (viz Jak na ChatGPT API pro překlad z a do češtiny) a souhrny (viz Jak na ChatGPT API pro souhrn článků na Internetu).
Vše zpracovává spellcheck.py – skript v Pythonu, který mi vlastně prakticky celý napsal Cursor a postupně jsem ho s jeho pomocí dolaďoval. Má ošetřené chybové stavy, umí dlouhé vstupy rozdělit na víc částí pro postupný překlad, dokončení signalizuje pípnutím. A samozřejmě, volá ChatGPT API.
Proměnné (jako API klíč, hlavně) má uložené v .env a co dělá, loguje do spellcheck.log, včetně doplnění informací o tom jak dlouho trvalo zpracování (iz příklad níže). Prompt má v extra souboru, spellcheck.prompt.txt, aby se to lépe aktualizovalo. Jen použitý model (aktuálně GPT-4o-mini, protože je levný a funguje to dost dobře) je nastavený přímo ve skriptu.
[2026-06-01 17:31:13] spellcheck.py start
[2026-06-01 17:31:13] Timing: load prompt 0.00s
[2026-06-01 17:31:13] Clipboard: HTML (412 chars)
[2026-06-01 17:31:13] Timing: clipboard read 0.44s (format=html, chars=412)
[2026-06-01 17:31:13] OpenAI request: 1 chunk, max_tokens=800
[2026-06-01 17:31:18] Timing: openai 5.30s (chars=412, max_tokens=800, model=gpt-4o-mini, chunk=1/1)
[2026-06-01 17:31:18] Timing: openai total 5.30s (format=html, chars=412)
[2026-06-01 17:31:19] Wrote HTML + plain companion to clipboard
[2026-06-01 17:31:19] Timing: clipboard write 0.25s (format=html, chars=417)
[2026-06-01 17:31:19] Done OK (417 chars out)
[2026-06-01 17:31:19] Timing: total 5.99s (format=html, chars_in=412, chars_out=417)
Prompt ostatně přišel z výše uvedené kontroly pravopisu v ChatGPT, jen tam zmizelo označování chyb a proběhlo nějaké drobné ladění.
ChatGPT je tady použitá přes API, stejně jako u těch příkladů výše a spotřeba je stále stejně minimalistická.
Způsob užití je prostě ten, že tam jde zkopírovat celý hotový text (co mám třeba v Google Docs) a poté ho vložit zpět. Nebo jeden či více odstavců, které jsem napsal do článku nebo newsletteru, opět copy a pak paste.
Jak to funguje
Přiznám se, že moc neřeším, co to vlastně vyrobilo. Prostě proto, že i kdyby to tam něco nechalo (nebo naopak něco vyrobilo), tak to rozhodně bude míň chyb, než které tam sekám já sám.
Klíč je v tom, že jsem si pár měsíců ověřoval ten prompt, den co den na článcích pro Ecoista.cz – a tam jsem viděl co vlastně opravuje. A ladil prompt, taby to opravdu dávalo smysl.
Jediný rozdíl v této API podobě je, že používají GPT-4o-mini, zatímco ten přes Canvas prostě aktuální GPT (ale pozor, OpenAI na konci května Canvas pro GPT 5.5 zařízlo) – ale pokud by 4o-mini dělalo něco, co nemá, dá se prostě jít na vyšší verzi (za cenu vyšších nákladů, ale stále dost legračních).
Pokud mám texty v Google Docs, tak ono přepsání původního opraveným navíc umožní se podívat do revizí a vidět co tam vlastně bylo změněné.
Používám to i na kontrolu článku pro Lidovky. Je to totiž efektivnější, než se je snažit kontrolovat vlastní hlavou. Ale tam po vložení AI opravy následuje čtení vlastní hlavou, tedy kontrola, jak to vlastně nakonec vypadá. Dost se hodí i tomu, že občas přeci jen opravím nějaké formulace, které jsem použil při psaní, ale dají se udělat lépe.
Vtip onoho promptu je, že má přísný zákaz cokoliv měnit – to je totiž u většiny LLM docela komplikace. Mají tendenci do vámi psaného textu a stylu zanášet své nápady. A tady prompt prostě opravdu řeší jen “spellcheck”. Překlepy, háčky, čárky, interpunkce, malá/velká písmena.
Jak vypadá prompt (spellcheck.prompt.txt)
Jsi nástroj na opravu pravopisu v textu ze schránky (HTML, RTF nebo prostý text).

Opravuj pouze:
- překlepy
- pravopis
- interpunkci

Neprováděj stylistické úpravy. Nepřeformulovávej věty a neměň slovosled ani význam.

Pravidla:
- Zachovej strukturu: odstavce, seznamy, řádkování.
- Jazyk textu zachovej (čeština zůstane česky, angličtina anglicky).
- Neměň čísla, datumy, e-maily, URL, kódy, značky produktů ani cizí termíny, pokud nejde o zjevný překlep.
- Nepřidávej nové věty, odstavce, komentáře ani vysvětlení. Nemaž obsah kromě zjevných přebytků z překlepu.

HTML a RTF:
- Opravuj jen viditelný text; neměň názvy tagů, atributy, styly, href, src ani strukturu markupu.
- Zachovej odkazy, URL a anchor text beze změny.
- Nerozbíjej syntaxi HTML/RTF (uzavřené tagy, escapování, entity).

Výstup:
- Vrať pouze opravený dokument ve stejném formátu jako vstup.
- U HTML: validní HTML, žádný markdown ani code bloky.
- U RTF: zachované RTF formátování.
- Bez značek, poznámek a souhrnů oprav.
Jak vypadá skript (spellcheck.py)
Kompletně vytvořený AI (Cursor) a poté ještě kontrola v další AI (Codex). Měl pochopitelně několik iterací, postupného přidávání funkčnosti. Důležitá maličkost, je napsaný pro macOS, protože využívá clipboard operačního systému. Přepsat to pro Windows by znamenalo jen spustit AI a požádat o to.
#!/usr/bin/env python3
import base64
import datetime
import json
import pathlib
import re
import subprocess
import sys
import time
import traceback
import urllib.error
import urllib.request
from typing import Optional

from openai_env import load_openai_config

HERE = pathlib.Path(__file__).resolve().parent
LOG_FILE = HERE / "spellcheck.log"
PROMPT_FILE = HERE / "spellcheck.prompt.txt"

MODEL = "gpt-4o-mini"
API_KEY, API_URL = load_openai_config()

MAX_INPUT_CHARS = 120_000
CHUNK_CHARS = 12_000


def log(msg: str) -> None:
    timestamp = datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S")
    with open(LOG_FILE, "a", encoding="utf-8") as f:
        f.write(f"[{timestamp}] {msg}\n")


def log_timing(label: str, elapsed: float, **details) -> None:
    extra = ", ".join(f"{k}={v}" for k, v in details.items())
    suffix = f" ({extra})" if extra else ""
    log(f"Timing: {label} {elapsed:.2f}s{suffix}")


def beep(sound_name: str = "Ping", times: int = 1, pause: float = 0.15) -> None:
    sound = f"/System/Library/Sounds/{sound_name}.aiff"
    for i in range(times):
        try:
            subprocess.run(["afplay", sound], check=False)
        except Exception:
            try:
                print("\a", end="", flush=True)
            except Exception:
                pass
        if i < times - 1:
            time.sleep(pause)


def load_system_prompt() -> str:
    if not PROMPT_FILE.is_file():
        raise FileNotFoundError(f"Chybí soubor promptu: {PROMPT_FILE}")
    return PROMPT_FILE.read_text(encoding="utf-8").strip()


def _run_osascript(script: str) -> str:
    proc = subprocess.run(
        ["osascript", "-l", "AppleScript", "-e", script],
        capture_output=True,
        text=True,
    )
    if proc.returncode != 0:
        raise RuntimeError(proc.stderr.strip() or f"osascript exit {proc.returncode}")
    return proc.stdout


def pasteboard_read_html() -> str:
    script = """
use framework "Foundation"
use scripting additions
set pb to current application's NSPasteboard's generalPasteboard()
set d to pb's dataForType:(current application's NSPasteboardTypeHTML)
if d is missing value then return ""
set s to current application's NSString's alloc()'s initWithData:d encoding:4
if s is missing value then return ""
return s as text
"""
    return _run_osascript(script).strip()


def pasteboard_write_html(html: str, plain: Optional[str] = None) -> None:
    payload = html.encode("utf-8")
    b64 = base64.b64encode(payload).decode("ascii")
    plain_b64 = ""
    if plain is not None:
        plain_b64 = base64.b64encode(plain.encode("utf-8")).decode("ascii")
        plain_block = f'''
set plainData to current application's NSData's alloc()'s initWithBase64EncodedString:"{plain_b64}" options:0
set plainStr to current application's NSString's alloc()'s initWithData:plainData encoding:4
pb's setString:plainStr forType:(current application's NSPasteboardTypeString)
'''
    else:
        plain_block = ""

    script = f"""
use framework "Foundation"
use scripting additions
set b64 to "{b64}"
set rawData to current application's NSData's alloc()'s initWithBase64EncodedString:b64 options:0
set pb to current application's NSPasteboard's generalPasteboard()
pb's clearContents()
pb's setData:rawData forType:(current application's NSPasteboardTypeHTML)
{plain_block}
"""
    _run_osascript(script)


def pbpaste_plain() -> str:
    raw = subprocess.check_output(["pbpaste"])
    try:
        return raw.decode("utf-8")
    except UnicodeDecodeError:
        return raw.decode("cp1252", errors="replace")


def pbpaste_rtf() -> str:
    raw = subprocess.check_output(["pbpaste", "-Prefer", "rtf"])
    try:
        return raw.decode("utf-8")
    except UnicodeDecodeError:
        return raw.decode("cp1252", errors="replace")


def pbcopy_plain(text: str) -> None:
    subprocess.run(["pbcopy"], input=text.encode("utf-8"), check=True)


def pbcopy_rtf(text: str) -> None:
    subprocess.run(["pbcopy"], input=text.encode("utf-8"), check=True)


def strip_html(html: str) -> str:
    text = re.sub(r"(?is)<(script|style).*?>.*?</\1>", " ", html)
    text = re.sub(r"(?s)<[^>]+>", " ", text)
    text = re.sub(r"\s+", " ", text)
    return text.strip()


def read_clipboard() -> tuple[str, str]:
    html = pasteboard_read_html()
    if html.strip():
        log(f"Clipboard: HTML ({len(html)} chars)")
        return "html", html

    rtf = pbpaste_rtf().strip()
    if rtf.startswith("{\\rtf"):
        log(f"Clipboard: RTF ({len(rtf)} chars)")
        return "rtf", rtf

    plain = pbpaste_plain().strip()
    if plain:
        log(f"Clipboard: plain text ({len(plain)} chars)")
        return "plain", plain

    return "plain", ""


def write_clipboard(fmt: str, content: str) -> None:
    if fmt == "html":
        pasteboard_write_html(content, strip_html(content))
        log("Wrote HTML + plain companion to clipboard")
        return
    if fmt == "rtf":
        pbcopy_rtf(content)
        log("Wrote RTF to clipboard")
        return
    pbcopy_plain(content)
    log("Wrote plain text to clipboard")


def format_instruction(fmt: str) -> str:
    if fmt == "html":
        return "Vstup i výstup je HTML. Zachovej všechny tagy a atributy."
    if fmt == "rtf":
        return "Vstup i výstup je RTF. Zachovej formátování RTF."
    return "Vstup i výstup je prostý text."


def estimate_max_tokens(text: str) -> int:
    return min(16_000, max(800, int(len(text) * 0.6) + 400))


def extract_content(data: dict) -> str:
    choices = data.get("choices", [])
    if not choices:
        raise RuntimeError(f"No choices in response: {json.dumps(data, ensure_ascii=False)}")

    message = choices[0].get("message", {})
    content = message.get("content", "")

    if isinstance(content, str):
        return content.strip()

    if isinstance(content, list):
        parts = []
        for item in content:
            if isinstance(item, dict):
                if item.get("type") == "text":
                    parts.append(item.get("text", ""))
                elif "text" in item and isinstance(item["text"], str):
                    parts.append(item["text"])
        return "".join(parts).strip()

    return str(content).strip()


def strip_markdown_fences(text: str) -> str:
    fenced = re.match(r"^```(?:html|rtf|text)?\s*\n(.*)\n```\s*$", text, flags=re.S | re.I)
    if fenced:
        return fenced.group(1).strip()
    return text


def strip_correction_markers(text: str) -> str:
    return re.sub(r"\s*\[OPRAVA\]", "", text, flags=re.I)


def call_openai(
    system_prompt: str,
    fmt: str,
    user_text: str,
    chunk_label: Optional[str] = None,
) -> str:
    if not API_KEY:
        raise RuntimeError("OPENAI_API_KEY is not set")

    max_tokens = estimate_max_tokens(user_text)
    payload = {
        "model": MODEL,
        "temperature": 0,
        "max_tokens": max_tokens,
        "messages": [
            {"role": "system", "content": system_prompt},
            {
                "role": "user",
                "content": (
                    f"{format_instruction(fmt)}\n\n"
                    f"Oprav následující text:\n\n{user_text}"
                ),
            },
        ],
    }

    req = urllib.request.Request(
        API_URL,
        data=json.dumps(payload).encode("utf-8"),
        headers={
            "Content-Type": "application/json",
            "Authorization": f"Bearer {API_KEY}",
        },
        method="POST",
    )

    t0 = time.perf_counter()
    with urllib.request.urlopen(req, timeout=180) as resp:
        raw = resp.read()
    data = json.loads(raw.decode("utf-8"))
    result = strip_correction_markers(strip_markdown_fences(extract_content(data)))
    elapsed = time.perf_counter() - t0
    details = {
        "chars": len(user_text),
        "max_tokens": max_tokens,
        "model": MODEL,
    }
    if chunk_label:
        details["chunk"] = chunk_label
    log_timing("openai", elapsed, **details)
    if not result:
        raise RuntimeError(f"Empty model response: {json.dumps(data, ensure_ascii=False)}")
    return result


def chunk_text(text: str, size: int) -> list[str]:
    if len(text) <= size:
        return [text]
    chunks = []
    start = 0
    while start < len(text):
        end = min(len(text), start + size)
        if end < len(text):
            split_at = text.rfind("\n\n", start, end)
            if split_at == -1 or split_at <= start + size // 2:
                split_at = text.rfind("\n", start, end)
            if split_at == -1 or split_at <= start + size // 2:
                split_at = text.rfind(" ", start, end)
            if split_at > start:
                end = split_at
        chunks.append(text[start:end].strip())
        start = end
    return [c for c in chunks if c]


def spellcheck_content(system_prompt: str, fmt: str, text: str) -> str:
    if len(text) > MAX_INPUT_CHARS:
        raise RuntimeError(
            f"Text je příliš dlouhý ({len(text)} znaků, limit {MAX_INPUT_CHARS})."
        )

    chunks = chunk_text(text, CHUNK_CHARS)
    if len(chunks) == 1:
        log(f"OpenAI request: 1 chunk, max_tokens={estimate_max_tokens(text)}")
        return call_openai(system_prompt, fmt, text, chunk_label="1/1")

    log(f"OpenAI request: {len(chunks)} chunks")
    corrected = []
    for idx, chunk in enumerate(chunks, 1):
        log(f"Chunk {idx}/{len(chunks)} ({len(chunk)} chars)")
        corrected.append(
            call_openai(
                system_prompt,
                fmt,
                chunk,
                chunk_label=f"{idx}/{len(chunks)}",
            )
        )
    return "".join(corrected) if fmt != "plain" else "\n\n".join(corrected)


def main() -> None:
    LOG_FILE.write_text("", encoding="utf-8")
    log("spellcheck.py start")
    t_total = time.perf_counter()

    if not API_KEY:
        log("ERROR: Missing API key")
        print(
            f"ERROR: OPENAI_API_KEY is not set (create {HERE / '.env'})",
            file=sys.stderr,
        )
        beep("Basso", 2, 0.2)
        sys.exit(1)

    try:
        t0 = time.perf_counter()
        system_prompt = load_system_prompt()
        log_timing("load prompt", time.perf_counter() - t0)
    except Exception as e:
        log(f"ERROR loading prompt: {e}")
        print(f"ERROR: {e}", file=sys.stderr)
        beep("Basso", 2, 0.2)
        sys.exit(1)

    t0 = time.perf_counter()
    fmt, content = read_clipboard()
    log_timing("clipboard read", time.perf_counter() - t0, format=fmt, chars=len(content))
    if not content:
        log("ERROR: Clipboard is empty")
        print("ERROR: Schránka je prázdná", file=sys.stderr)
        beep("Basso", 2, 0.2)
        sys.exit(1)

    try:
        t0 = time.perf_counter()
        result = spellcheck_content(system_prompt, fmt, content)
        log_timing("openai total", time.perf_counter() - t0, format=fmt, chars=len(content))
    except urllib.error.HTTPError as e:
        body = e.read().decode("utf-8", errors="replace")
        log(f"HTTP {e.code} ERROR: {body[:2000]}")
        print(f"HTTP {e.code} ERROR: {body}", file=sys.stderr)
        beep("Basso", 2, 0.2)
        sys.exit(1)
    except urllib.error.URLError as e:
        log(f"NETWORK ERROR: {e}")
        print(f"NETWORK ERROR: {e}", file=sys.stderr)
        beep("Basso", 2, 0.2)
        sys.exit(1)
    except Exception as e:
        log(f"SPELLCHECK ERROR: {e}")
        log(traceback.format_exc())
        print(f"ERROR: {e}", file=sys.stderr)
        beep("Basso", 2, 0.2)
        sys.exit(1)

    t0 = time.perf_counter()
    write_clipboard(fmt, result)
    log_timing("clipboard write", time.perf_counter() - t0, format=fmt, chars=len(result))
    log(f"Done OK ({len(result)} chars out)")
    log_timing(
        "total",
        time.perf_counter() - t_total,
        format=fmt,
        chars_in=len(content),
        chars_out=len(result),
    )
    beep("Glass", 1)


if __name__ == "__main__":
    try:
        main()
    except Exception as e:
        log(f"FATAL ERROR: {e}")
        log(traceback.format_exc())
        print(f"ERROR: {e}", file=sys.stderr)
        beep("Basso", 2, 0.2)
        sys.exit(1)
Jak vypadá openai_env.py
Pomocný skript pro načtení API KEY a API URL, který se využívá i v jiných skriptech. Nemá smysl, aby tahle část kódu byla znovu a znovu v každém skriptu. A API KEY je něco, co je velmi vhodné nemít přímo ve skriptu (ale v .env).
"""Načtení OpenAI konfigurace z .env vedle skriptů nebo z prostředí."""
import os
import pathlib

HERE = pathlib.Path(__file__).resolve().parent
DEFAULT_API_URL = "https://api.openai.com/v1/chat/completions"


def load_openai_config() -> tuple[str, str]:
    try:
        from dotenv import load_dotenv

        load_dotenv(HERE / ".env")
    except ImportError:
        pass

    api_key = os.environ.get("OPENAI_API_KEY", "").strip()
    api_url = os.environ.get("OPENAI_API_URL", DEFAULT_API_URL).strip() or DEFAULT_API_URL
    return api_key, api_url
Další tipy týkající se Pythonu