Pár posledních týdnů pomáhám s vydáním knížky o AI (od Lukáše Sedláčka) a mimo to, že už ji mám skoro přečtenou (skvělé čtení), tak jsme potřebovali z knihy dostat i různé “výkřiky”. Do PPC, na socnety, na zadní stranu, atd. A tak nějak „si s knihou povídat“.
Je to knížka o AI, takže proč nevyužívat AI pro to, co by měla umět dobře. Takže si řeknete, že prostě vezmete PDF celé knihy a nahrajete ho do AI (ChatGPT). Což jde v pohodě, má jen pár set stránek, takže se tam “vejde”.
Ale v okamžiku kdy se začnete ptát na konkrétní věci v obsahu, tak zjistíte … že ChatGPT si suverénně vymýšlí.
Neví kolik to má kapitol, nedokáže správně uvést číslo stránky pokud chcete vědět odkud něco vybrala. A u výběru ani dokáže citovat, kompletně si vymýšlí i celé texty, byť jsou tak nějak “založené” na něčem, co v knize skutečně je.
Pak navíc začne říkat, že něco nejde, co ještě před chvíli šlo.
Paradoxně to není problém nedostatku tokenů, tedy toho, že by knížka byla moc velká, ale něčeho úplně jiného
Dávejte AI strojově čitelná data
PDF je ten nejméně vhodný formát pro nahrávání do AI. Stejně tak jako je to ten nejméně vhodný formát, pokud něco posíláte novinářům, nebo prostě někam, kde potřebují z toho PDF dostat původní nepoškozený text.
TIP: Což je mimochodem i klíčové ve zcela jiném případě, viz Tiskové zprávy se v PDF nikdy neposílají. Zopakujeme si to. Nikdy
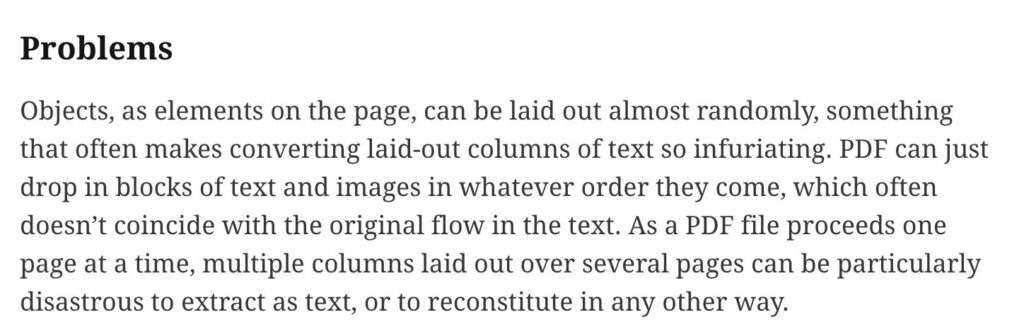
AI prostě neustále narážela na to, že uvnitř PDF je vše ve formě přizpůsobené pro zobrazení a tisk. Zjednodušeně věci tam vlastně nejdou ani správně za sebou, nejsou strukturovaná a rozpoznatelná.
V tomhle případě navic problémy dělalo i to, že hodně stránek knížky byly zdroje (Lukáš Sedláček neuvěřitelně precizně vše o čem píše zdrojuje) a tohle dělalo kupu dalších problémů.
Nakonec jsem ručně PDF “očesal” aby tam byly opravdu jen stránky s textem knihy. A ještě navíc uložil v “linearizované” (PDF Linearization) podobě. Ta může pomoci tím, že věci v PDF jdou postupně za sebou. NIkoliv bez správného pořadí. Bylo to rychlejší než PDF převést na Markdown (nebo klidně i Word).
POZNÁMKA: Některá PDF je nutné prohnat OCR, aby vůbec bylo možné získat původní text. To je pro AI ještě horší.
Pak už ChatGPT dělala co měla – správná čísla stránek, do písmenka správné icitace.
Nedávejte AI PDF soubory
Čistě prakticky je nejlepší předložit AI knihu ve Wordu, ideálně, HTML, čistém textu (klidně i RTF). Všechno jsou to formáty, které jsou daleko lépe strojově čitelné (zpracovatelné). AI navíc PDF čte s pomocí knihoven v Pythonu, takže tam mohou vznikat spousty dalších komplikací. Knihovny jako pdfplumber, PyMuPDF vnášejí vlastní chyby.
Výhoda Wordu, HTML či RTF je, že umí zachovat kapitoly, nadpisy, odstavce, odkazy. AI pak chápe kontext (např. že něco je poznámka pod čarou, ne hlavní text). V PDF se tohle rozbije. AI navíc nahrané věci tokenizuje a rozseká na kusy – v PDF opět může dojít k tomu, že se bude v rozsekaných blocích ztrácet.
PRAVIDLO: Cokoliv ChatGPT předkládáte by mělo být strojově čitelné, strukturované (je to mimochodem ideální i pro prompty, hodně to pomůže) a obsahovat metadata.
Takže například tabulku tam tk< nedávejte v PDF, ale ideálně jako CSV, případně XLS. Skutečně spíš to CSV, protože i XLS je už komplikovanější.
ChatGPT navíc umí poradit, prostě to s ní nejdřív proberte – co máte za data, můžete je tam i nahrát v podobě co máte, a ať vám řekne jaký by byl ideální formát (a nezapomeňte ji říct co bude zpracovávat).
Skvělé vysvětlení toho, proč je PDF peklo a absolutně se nehodí k šíření dokumentů co je potřeba použít dál jinak než jen zobrazit nebo vytisknout.
RAG nebo CustomGPT nebo Projekt
Pro složitější věci (knihy, rozsáhlé tabulky, datové sady) se standardně používá RAG (Retrieval Augmented Generation) – místo nahrání obřího souboru se data uloží do databáze, indexují a AI se k nim dotazuje. To ale v klasickém využít ChatGPT nemůžete využít. Jedině pokud se vydáte do použití CustomGPT a napojení přes API – reálně se to dělá tak, že se vezme GPT přes API a k tomu vektorová databáze a middleware co to spojí.
V Custom GPT je to ale také trošku jiné – ale pořád ne úplně plnohodnotné RAG, jak se dělá ve firmách. Jde tam nahrát soubory a CustomGPT je používá jako znalostní bázi. Funguje to podobně jako jednoduchý RAG. GPT si při dotazu vytáhne relevantní kousky z těch nahraných souborů a vloží je do promptu. Ale stále platí, že PDF prostě nejsou strukturovaná a strojově zpracovatelná data.
Do CustomGPT jde nahrát maximálně 20 souborů, limit 512 MB na souborů a navíc 2 miliony tokenů na soubor u textů/dokumentů, u tabulek cca 50 MB. Pro jednoho uživatele ja tam maximální uložiště 10 GB, pro organizace 100 GB. Jsou tam i omezení počtu nahrávání podle plánu (free vs. placené).
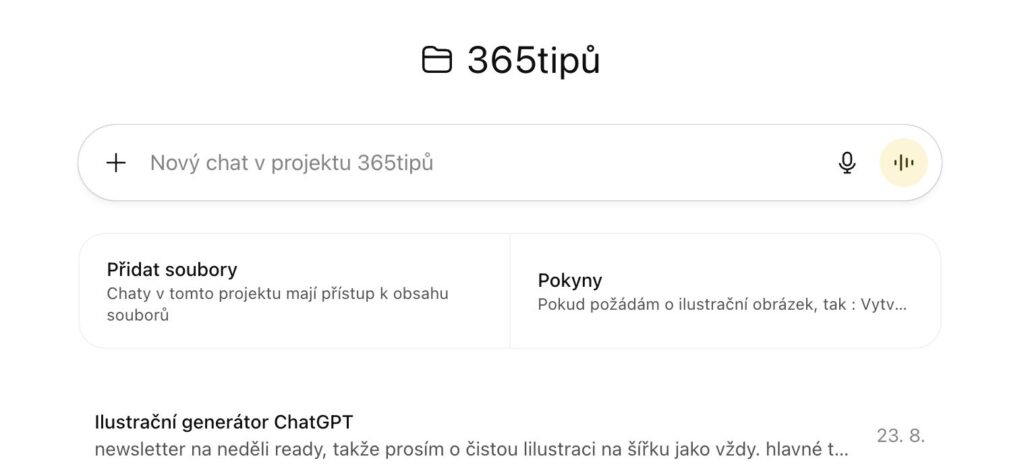
Ještě je tu ale cesta přes Projekt – tam totiž můžete nahrát soubory na úrovní projektu a chová se to stejně jako CustomGPT. A platí i stejná omezení jako v CustomGPT. Stejně jako všude dříve, i zde jde nahrávat soubory textové (TXT, DOCX, RTF, MD, HTML), tabulkové (CSV, XLSX), a také PDF Výhoda u Projektu je, že můžete nastavit omezení paměti, čistě na prostor projektu.
CustomGPT je výhodné v tom, že ho mohou využívat i další lidé – získají “chytré” GPT s nahranými soubory a jedou si vlastní chaty. Projekt je váš, případně týmový. A lze tam mít víc chatovacích vláken.
Halucinace? Stejně mohou být
Pozor ale, AI si ráda „halucinuje“ zdroje i z dobře připraveného textu. Není to jen formátem, ale povahou modelu. Proto je vždy nutné dělat kontrolu. A zvolit odpovídající model, je dost velký rozdil mezi plným nebo „mini“.
Další tipy týkající se AI (ChatGPT a další)