Anthropic zavádí do výstupů Claude strojově čitelné značení, podle kterého půjde později poznat, že text nebo soubor/obrázek/atd prošel přes jeho AI. Internetem se kolem toho okamžitě rozjela dezinformační kampaň, podle které bude Claude „označovat vodoznakem každé jednotlivé slovo“. A protože správná dezinformace potřebuje viníka, může za to samozřejmě „zlá EU“.
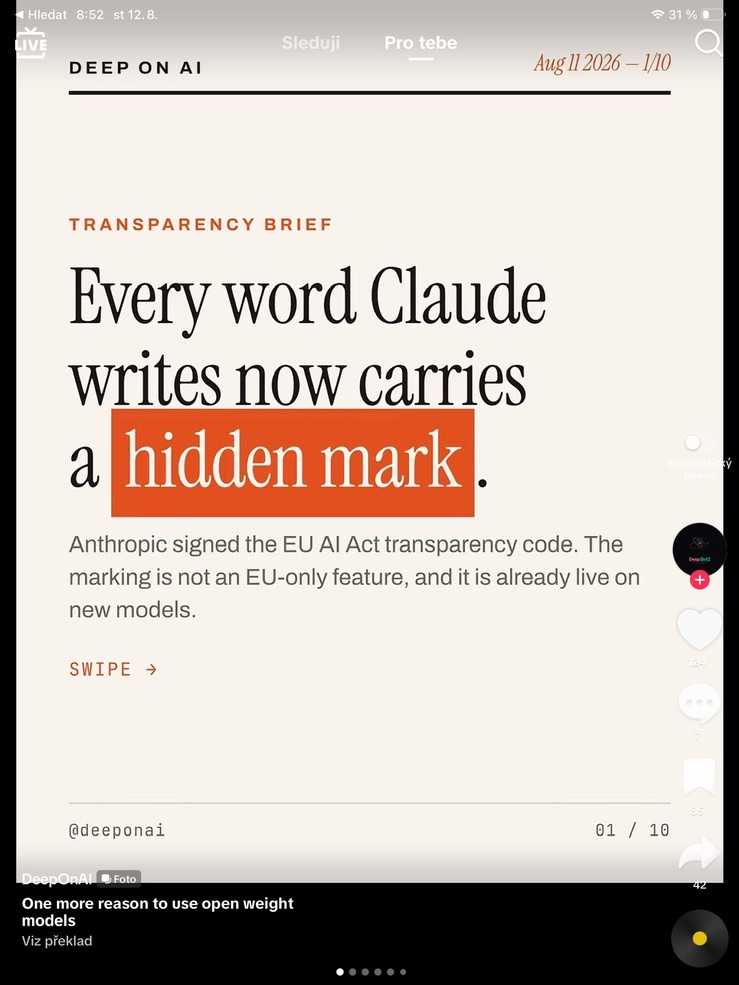
Realita je podstatně méně dramatická. První tvrzení je výmysl a druhé účelové zkreslení toho, co Evropská unie skutečně požaduje.
Anthropic skutečně oznámil, že podporované modely Claude budou do generovaného textu přidávat neviditelný strojově detekovatelný vodoznak. U podporovaných souborů, například PNG, JPG nebo SVG, bude používat podepsaná metadata o původu podle standardu C2PA.
Nové modely uvedené v EU 2. srpna 2026 nebo později mají značení podporovat od uvedení. U dříve vydaných modelů ho Anthropic postupně doplňuje. Přesný aktuální seznam starších modelů, kde už značení funguje, zatím nezveřejnil. Aktuálně je důležité i to, že od 2. srpna prozatím nebyl uveden žádný nový model.
Značení se navíc nebude týkat jen Evropské unie. U podporovaných modelů ho Anthropic zavádí celosvětově v Claude, API, Claude Code, Claude Cowork, Claude Tag i při použití modelů přes AWS, Google Cloud nebo Microsoft Foundry.
Ne, každé slovo nemá vlastní vodoznak
Anthropic nikde netvrdí, že by „označoval vodoznakem každé jednotlivé slovo“. Popisuje pouze neviditelný vodoznak vložený přímo do textu. Má přežít zkopírování a vložení textu jinam a může přežít i některé následné úpravy.
Jak přesně to Anthropic technicky dělá, původně oznámeno nebylo Pár dni po napsání tipu se objevují další informace: Anthropic popisuje vodotisk textu Claude : ukazuje pouze to, že Claude pravděpodobně byl zapojen, je stručný v kódu a v textu a zmizí po úplném přepracování. (AnthropicAI)
Část zmatku může pocházet z jiných technologií. Google u svého SynthID například skutečně popisuje ovlivňování pravděpodobností tokenů při generování textu. Podrobněji už o SynthID byla řeč na 365tipů.
Ani tam ale neznamená „model pracuje s každým tokenem“ totéž jako „každé slovo obsahuje samostatný vodoznak“. A token navíc vůbec nemusí být celé slovo.
U Claude je velmi dobrým protiargumentem samotný Anthropic: upozorňuje, že velmi krátký text nemusí obsahovat dostatek signálu pro spolehlivou detekci. Kdyby každé jednotlivé slovo neslo samostatně detekovatelný vodoznak, nedávalo by takové omezení smysl.
TIP: Textový vodoznak od Anthropic mění pravděpodobnosti slov, aby vložil otisk, což by mohlo zhoršit psaní Claude, ačkoliv tvrdí, že to nemá vliv na kvalitu. (Daring Fireball)
A co s tím má společného ta „zlá EU“?
Poměrně hodně, ale rozhodně ne to, co tvrdí zmíněná kampaň.
Od 2. srpna 2026 platí transparentní povinnosti podle článku 50 AI Actu. Poskytovatelé generativních AI systémů mají zajistit, aby jejich syntetické texty, obrázky, video či audio nesly strojově čitelné značení umožňující rozpoznat, že byly vytvořeny nebo upraveny AI.
EU ale nenařizuje konkrétní technický způsob, jak to má výrobce udělat. Požaduje, aby použité řešení bylo podle současných technických možností efektivní, interoperabilní, robustní a spolehlivé. Nikde není požadavek „vložte značku do každého slova“.
Vedle samotného zákona vznikl také Code of Practice on Transparency of AI-generated Content. Přistoupení ke kodexu je dobrovolné, zákonné povinnosti nikoliv. Anthropic kodex podepsal a právě v návaznosti na něj popsal, jak hodlá značení řešit.
Není v tom sám. Mezi signatáři části kodexu pro poskytovatele jsou vedle Anthropicu například Google, Meta, Microsoft, Mistral nebo OpenAI.
Proč vůbec AI obsah označovat?
Smyslem není trestat používání AI ani někomu „cejchovat“ text. Generovaný obraz, zvuk, video i text je stále obtížnější odlišit od autentického obsahu. To usnadňuje podvody, vydávání se za jiné osoby, manipulace, deepfakes nebo masové šíření dezinformací.
Strojově čitelné označení přidává další informaci o původu. Systém, vyhledávač, sociální síť, redakce nebo jiný nástroj se může například dozvědět, že určitý obsah prošel generativní AI.
Je to přitom podstatně lepší cesta než dnešní pokusy „poznat AI podle stylu“. Jak už bylo podrobněji v Detekce AI textu. K čemu je dobrá, kdy funguje a kdy ne, běžné AI detektory pouze odhadují podle vlastností textu a mohou se velmi snadno splést.
Watermark je naopak vložený přímo při generování poskytovatelem modelu. Ani ten ale není neomylný.
Vodoznak neznamená „tohle napsala AI“
Tohle je nejdůležitější.
Anthropic sám upozorňuje, že nalezený vodoznak pouze signalizuje, že text mohl být zpracován Claude. Nemusí znamenat, že Claude text od začátku napsal.
Stačí například vzít vlastní text a nechat ho přes Claude přeložit, shrnout nebo jazykově přepracovat. Výstup potom může značku nést, přestože původní myšlenky a velká část textu pocházejí od člověka.
Stejně tak nalezený watermark neříká nic o tom, zda je text pravdivý, kvalitní, ukradený nebo podvodný. Je to informace o původu či zpracování, nikoliv známka kvality.
A platí to i obráceně. Nenalezený vodoznak není důkaz, že text napsal člověk. Značka může chybět u staršího modelu, může se ztratit výrazným přepsáním, parafrázováním, překladem nebo smícháním s jiným textem. Příliš krátký úryvek navíc nemusí obsahovat dostatek signálu pro spolehlivou detekci.
Ve výsledku je to stejný princip jako u SynthID: přítomnost značky něco užitečného říká, její nepřítomnost ale není „certifikát lidského původu“.
Zatím si watermark sami neověříte
Další podstatný detail: Anthropic zatím veřejný detekční nástroj ani technickou dokumentaci k detekci nezpřístupnil.
Firma slibuje, že uživatelům a třetím stranám umožní značky ověřovat, ale podrobnosti teprve zveřejní. Pokud tedy dnes někdo tvrdí, že má spolehlivý způsob, jak v libovolném textu poznat nový Claude watermark, měl by také velmi dobře vysvětlit, odkud takovou schopnost vzal.
U obrázků a souborů jde o něco jiného
U podporovaných souborů používá Anthropic podepsaná metadata podle standardu C2PA. To není totéž jako textový watermark.
C2PA může nést ověřitelné informace o původu a zpracování souboru a dovoluje zjistit, zda s podepsanými údaji někdo manipuloval. Má ale také vlastní omezení, především možnost ztráty metadat při některých převodech, exportech nebo pořízení screenshotu.
Podrobněji je to vysvětlené v Co je to C2PA/Content Credentials a jak to pomůže poznat, zda fotka pochází od AI.
Ani EU nechce nálepku na každý text, kterého se dotkla AI
Tady vzniká ještě jeden zbytečný strašák. Povinnost poskytovatele vložit do AI výstupu strojově čitelné značení není totéž jako povinnost všude viditelně napsat „TOTO VYTVOŘILA AI“.
Evropská pravidla mají řadu výjimek. U textů zveřejňovaných za účelem informování veřejnosti se viditelné označení týká AI generovaného nebo upraveného obsahu o věcech veřejného zájmu. Pokud ale text prošel skutečnou lidskou kontrolou nebo redakčním řízením a někdo za jeho zveřejnění nese redakční odpovědnost, označení vyžadováno není.
Stejně tak samotný článek 50 obsahuje výjimku pro AI, která pouze pomáhá se standardními úpravami a podstatně nemění vstupní obsah nebo jeho význam.
Takže nikoliv, Evropská unie nevymyslela systém, který má tajně označkovat každé slovo napsané s pomocí AI.
Vymyslela požadavek, aby syntetický obsah mohl nést technicky ověřitelnou informaci o svém původu. O konkrétním provedení rozhodují poskytovatelé. A u Claude o tom, jak přesně textový watermark funguje, zatím Anthropic zdaleka neřekl všechno.
Dokud technickou dokumentaci nevydá, je nejlepší zacházet se sebejistými popisy typu „víme přesně, co Claude schovává do každého slova“ přesně tak, jak si zaslouží: jako s nepodloženým tvrzením.
Další tipy týkající se AI (ChatGPT a další)