TLDR? Tokeny jsou jednotka, ve které AI počítá text; kontextové okno je omezený pracovní prostor, do kterého se musí vejít zadání, historie, přílohy i odpověď a když ho zahltíte, AI začne zapomínat, zkracovat a chybovat.
Claude nově oznámila kontextové okno o velikosti jeden milion tokenů a dost vhodné se na tuhle zásadní vlastnost jazykových modelů (LLM) trochu zaměřit. Je to totiž důležité.
Možná jste na to totiž už narazili. Dlouho si povídáte s ChatGPT (ale opravdu dlouho) a ona vám náhle řekne, že už v konverzaci nejde pokračovat, že byla překročení maximální délka konverzace. Řešení je jedině takové, že založíte nových chat a řeč už o tom mimochodem byla v Časté chyby při práci s ChatGPT a LLM vůbec
Na vině této komplikace je to, že AI pracují s kontextovým oknem do kterého se vejde jenom určitý počet tokenů. A čím déle si spolu povídáte (a zároveň čím delší jsou vaše zadání a následné odpovědi od AI), tím víc se onen dostupný prostor zaplní.
Co je kontextové okno
Kontextové okno je množství tokenů (o kus dál si vysvětlíme), které model v daném okamžiku „vidí“ a může použít při generování odpovědi. Je to něco jako pracovní paměť, ne dlouhodobá paměť a už vůbec ne celý trénink modelu. Právě to rozhoduje, jak dlouhý rozhovor, dokument nebo balík instrukcí AI ještě zvládne držet.
Velké kontextové okno dovolí zpracovat dlouhé zadání, více dokumentů, delší historii chatu nebo složitější workflow. Neznamená ale automaticky lepší přesnost, lepší logiku ani to, že si model vše stejně dobře zapamatuje a využije. Anthropic i Google výslovně řeší „long context“ jako samostatnou disciplínu a doporučují s ním aktivně pracovat, ne jen bezhlavě přidávat text.
Měli byste vědět i to, že omezení dané kontextovým oknem AI řeši i tak, že “zapomínají” nebo nějak “komprimují” věci z počátků vaší konverzace. Což je běžně i důvod k tomu, že dlouhé konverze mohou později tíhnout k zmateným odpovědim.
Velké okno prostě neznamená, že model stejně dobře pracuje s první i poslední částí vstupu. V praxi se ztrácí detaily, model přehlíží důležité pasáže, míchá priority nebo ignoruje část instrukcí. U dlouhého kontextu navíc roste cena (při přístupu přes API), zpoždění odpovědí a riziko, že v promptu zůstane starý či irelevantní balast.
Doporučení je jednoduché: necpat do AI všechno. Nejdřív vyčistit zadání, oddělit důležité od nedůležitého, rozdělit problém na kroky a dlouhé materiály raději shrnout nebo dávkovat po částech. Velké okno je užitečné, ale není to omluva pro nepořádek.
Co jsou tokeny
Token je základní jednotka textu, se kterou model pracuje. Není to totéž co slovo ani znak. Jeden token může být krátké slovo, část slova, interpunkce i mezera. To je důležité proto, že skoro všechno v AI se počítá právě v tokenech: vstup, výstup, cena, limity i to, kolik textu se vejde do jedné konverzace (do kontextového okna).
Tokeny jsou tedy měrná jednotka. Umožňují odhadnout, kolik textu se do modelu vejde a kolik to bude stát. Neumí ale uživateli dát intuitivní představu, protože „1000 tokenů“ neznamená pevný počet slov či znaků. Záleží na jazyce, stylu, číslech, kódu i formátování.
Praktické odhady typu „1 token = 4 znaky“ fungují jen orientačně a hlavně pro angličtinu. U jiných jazyků, u tabulek, zdrojáků, seznamů, URL, JSONu nebo textu s hodně čísly může být poměr jiný.
Nepočítejte znaky, slova ani stránky, počítejte s rezervou. Dlouhé zadání, dlouhý chat, vložené dokumenty a dlouhá odpověď se sčítají. Kdo chce jistotu, musí použít nástroj na počítání tokenů nebo vestavěné počítání v API.
Tokeny vstupu a tokeny výstupu
Do limitu se obvykle počítá nejen to, co napíše uživatel, ale i to, co má vrátit model. U řady systémů se počítá kombinace vstupu a výstupu, případně má model zvláštní strop pro výstup. To je důležité, protože dlouhý prompt může „sežrat“ prostor pro odpověď.
Můžete modelu říct, aby odpovídal kratčeji, nebo mu nastavit limit odpovědi. To pomáhá, ale neřeší to přeplněný kontext. Když do okna nacpete příliš mnoho vstupu, model může začít ořezávat historii, selhat, nebo odpovědět neúplně.
Lidé často řeší jen délku promptu a zapomenou, že potřebují prostor i pro odpověď. V některých systémech je to výslovně vidět: například OpenAI uvádí, že maximální kontext musí pokrýt vstup i výstup, a u některých režimů uvádí oddělené limity input/output.
Takže, čím delší podklady vkládáte, tím stručnější musí být očekávaný výstup. Když chcete nahrát dlouhý dokument, neměli byste chtít hned desetistránkovou analýzu v jednom kroku.
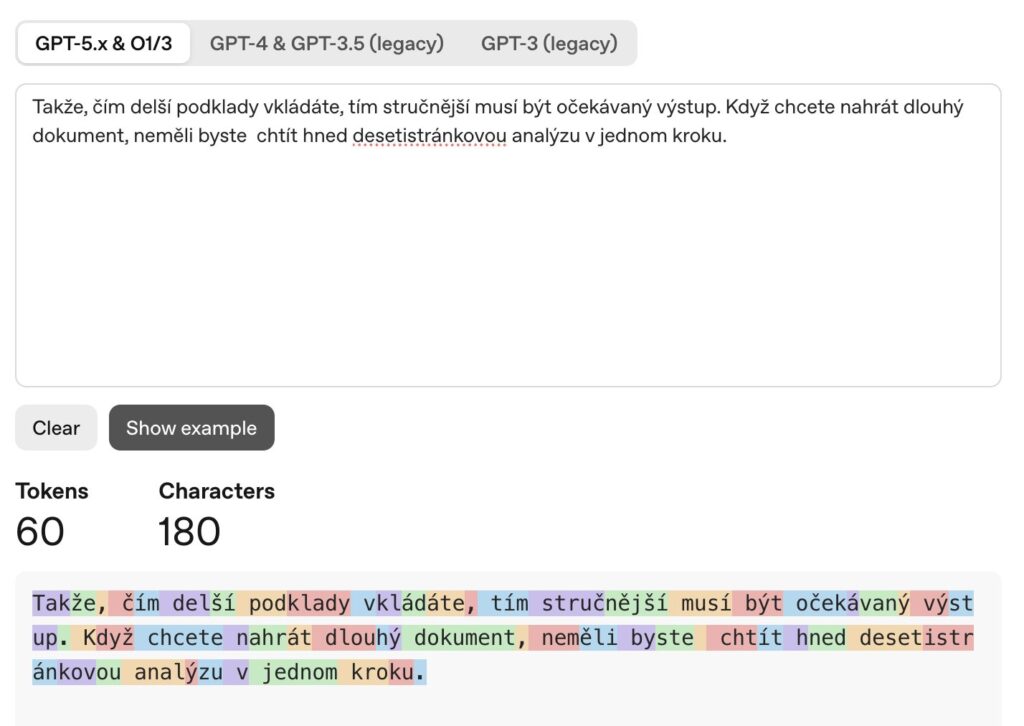
TIP: Jak zjistit počet tokenů nějakého textu? Pomocí nástrojů co to spočítají – OpenAI má Tokenizer na webu a tiktoken pro použití v API. Podobné možnosti mají i další AI.
Kontextové okno není totéž co „paměť“ ani „znalosti modelu“
Model může mít velké kontextové okno, ale přesto nemusí „vědět“ aktuální fakta, pokud je nemá ve vstupu nebo nemá přístup k webu. Stejně tak může být v rámci jednoho chatu schopen držet historii, ale to neznamená, že si ji bude pamatovat navždy. Kontext je pracovní prostor pro aktuální běh.
Kontext umí držet zadání, historii, dokumenty a pravidla pro aktuální odpověď. Neumí sám od sebe zajistit aktuálnost, pravdivost ani trvalé uložení informací do budoucna.
Tady vzniká klasická chyba: „Vždyť jsem to modelu psal před chvílí.“ Ano, ale pokud už byla starší část konverzace zkrácena, komprimována nebo vyhozena z kontextu, model s ní už nemusí pracovat.
Tady je zásadní znát řešení: důležité instrukce opakovat nebo shrnout znovu, zvlášť v dlouhém vlákně. Když je něco klíčové, má to být v posledním zadání, ne schované o 40 zpráv výš.
Proč dlouhý chat časem degraduje
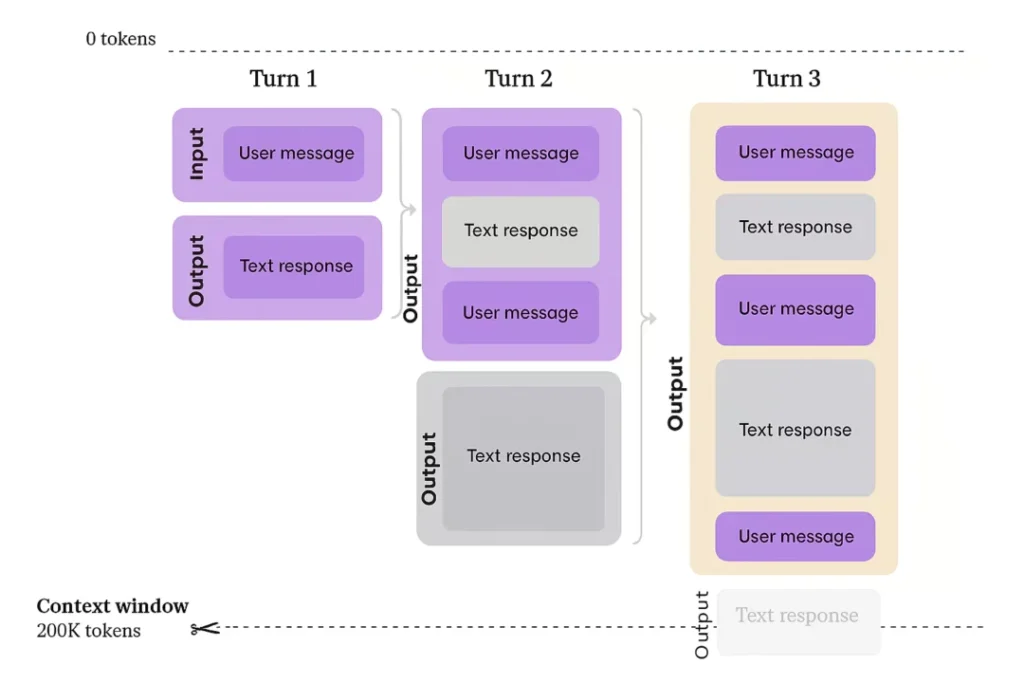
S každou další zprávou přibývají tokeny historie. To znamená, že i když uživatel píše jen krátce, předchozí komunikace může zabrat velkou část kontextového okna. Výsledkem je, že chat začne být méně přesný, zapomíná dřívější omezení nebo si protiřečí.
Necháváme se trochu oklamat tím, že si s AI povídáme v Chatu a že vidíme celou historii. Realita ale je, že náš každý nový požadavek/sdělení vyžaduje, aby AI znovu načetla a zpracovala vše předchozí.
Dlouhé vlákno je pohodlné pro navazování práce. Neumí ale udržet nekonečně mnoho detailů se stejnou kvalitou. Systém může starší části zkracovat, zahazovat nebo komprimovat.
Při používání to pak vypadá, že model „zhloupl“. Ve skutečnosti bývá problém prostší: důležité informace se do aktivního kontextu už nevejdou, nebo jsou zředěné obrovským množstvím balastu.
Tady je řešním po delší práci udělat restart vlákna a vložit jen čisté shrnutí: cíl, omezení, fakta, co už je hotovo a co má AI udělat teď. To bývá lepší než pokračovat ve stokilometrovém chatu.
Nahrané soubory a dokumenty: „vešlo se“ neznamená „je to celé v hlavě modelu“
Tohle je také velmi důležitá a často opomíjená oblast. Uživatel nahraje PDF nebo DOCX a myslí si, že model „má celý dokument v hlavě“. Jenže u některých systémů se do aktivního kontextu dostane jen část textu a zbytek je dostupný přes vyhledávání nebo výběr relevantních úryvků. OpenAI to popisuje u práce se soubory výslovně jako optimalizaci nahraných souborů.
AI pak umí to pracovat i s velkými dokumenty a z nich tahat relevantní části. Neumí to garantovat, že model při každé odpovědi skutečně zohlední celý dokument od začátku do konce.
OpenAI uvádí, že textové a dokumentové soubory mohou mít limit až 2 miliony tokenů na soubor, ale to neznamená, že se celý dokument najednou vejde do kontextu. U ChatGPT Enterprise OpenAI píše, že ne všechny tokeny z uploadu jsou „stuffed“ do kontextu; část může skončit v interním indexu pro dohledávání.
U velkého dokumentu je prostě vždy vhodné říct, co přesně má AI hledat. Ne „přečti to a řekni mi vše“, ale „najdi v tom smluvní pokuty“, „vypiš změny oproti verzi A“, „shrnuj jen kapitoly 3–5“. U dlouhých souborů je přesné zadání důležitější než velikost kontextu.
Obrázky, audio, video a PDF také žerou tokeny nebo jejich ekvivalent
Lidé často počítají jen text. Jenže multimodální modely zpracovávají i obrázky, PDF, zvuk či video, a i to se promítá do limitů. Gemini to uvádí přímo u token counting a media resolution, Anthropic uvádí limity pro počty a velikosti obrázků.
AI umí analyzovat kombinaci textu a médií. Neumí to ale dělat zdarma z hlediska kapacity, multimédia mohou kontext rychle nafouknout.
U obrázků a videa uživatel často netuší, kolik kapacity to stojí. Výsledkem je, že k obrázkům přidá ještě dlouhé instrukce a pak se diví, že odpověď je stručná nebo nestabilní. Google výslovně uvádí, že rozlišení médií mění tokenový dopad.
Když posíláte médium, zkraťte textové zadání na minimum a dejte jasný úkol. Třeba „najdi chyby v tabulce na obrázku“ nebo „porovnej tyto dva screenshoty“.
Do tokenů se mohou počítat i systémové instrukce, nástroje a technická omáčka
V API a agentních scénářích se do vstupu nepočítá jen uživatelův text, ale i systémové instrukce, definice nástrojů, parametry funkcí a další struktura požadavku. Google to uvádí explicitně u function calling, Anthropic doporučuje cachovat – definice i historii.
Tohle na jednu stranu umožňuje složitější automatizace, ale zároveň zmenšuje to prostor pro samotný obsah. Neumí to obejít fyzikální realitu kontextu: všechno se někam musí vejít.
Pro běžného uživatele v chatu to není tolik vidět, ale u vlastních AI workflow je to zásadní. Vývojář si myslí, že posílá „jen krátký prompt“, ve skutečnosti posílá obří systémový balík a dvacet funkcí.
Čím tokeny a kontextové okno omezují AI v praxi
Pojďme to trochu shrnout.
a) Omezují délku zadání – Čím víc instrukcí, textu, příloh a historie, tím méně místa zbývá. Doporučení: nepoužívat „prompt smetiště“. Vyházet vatu, duplicity, staré pokyny.
b) Omezují délku odpovědi – Dlouhá odpověď potřebuje vlastní tokenový rozpočet. Doporučení: u dlouhých úkolů chtít výsledek po částech.
c) Omezují kontinuitu dlouhých chatů – Historie se nevejde donekonečna. Doporučení: po delším vlákně začít nový chat se shrnutím.
d) Omezují práci s velkými dokumenty – Nahraný dokument nemusí být celý najednou v aktivním kontextu. Doporučení: dávat konkrétní otázky a odkazy na části dokumentu.
e) Omezují cenu a rychlost – Více tokenů znamená obvykle vyšší cenu a delší zpracování a proto výrobci nabízejí token counting a prompt caching. Doporučení: u opakovaných úloh znovu neposílat ten samý dlouhý kontext, když platforma umí cache.
f) Omezují spolehlivost – Dlouhý a špatně organizovaný kontext snižuje šanci, že model vybere správné informace. Doporučení: strukturovat, shrnovat, prioritizovat.
OpenAI v aktuálních materiálech uvádí u ChatGPT různé kontexty podle režimu a tarifu. Například u GPT-5.4 Thinking v placených tarifech 256k a u Pro 400k, zatímco Fast má méně.
Google u Gemini 3.1 Pro Preview uvádí vstupní limit 1,048,576 tokenů a výstup 65,536 tokenů.
Anthropic uvádí, že 1M token context window je obecně dostupné pro Claude Opus 4.6 a Sonnet 4.6.
Ale pozor. „Konkrétní čísla se rychle mění, proto vždy kontrolujte limity přímo u služby, kterou používáte.“
Co umí velké kontextové okno dobře
Velké okno je užitečné tam, kde je potřeba porovnávat dlouhé texty, držet více omezení najednou, analyzovat delší dokumenty nebo navazovat v delší práci.
Umí zpracovat velké množství vstupu. Neumí zaručit, že každý detail využije stejně dobře. Větší okno není automatická záruka lepší práce.
Ale pozor, lze snadno nabýt dojmu, že „s milionem tokenů mohu bez obav hodit do AI celou firmu“. Technicky to někdy jde, prakticky je to často drahé, pomalé a méně přehledné, než rozumně připravený výběr podkladů
Nejčastější chyby uživatelů
- Pletou si token se slovem.
- Myslí si, že kontextové okno = paměť napořád.
- Myslí si, že nahraný dokument je celý „v hlavě“ modelu.
- Nechávají chat bobtnat a pak se diví horším výsledkům.
- Chtějí příliš dlouhé zadání i příliš dlouhou odpověď zároveň.
- Neopakují klíčové instrukce v dlouhém vlákně.
- Nevědí, že média, nástroje a systémové instrukce také spotřebují kapacitu.
Další tipy týkající se AI (ChatGPT a další)