Při úklidu v mém FreshRSS jsem zjistil, že existují RSS feedy, které neustále vrací tisíce položek. Třeba české Wired, které do něj dává úplně všechno za roky zpět, ačkoliv to nedává smysl.
Pro RSS čtečku jako je FreshRSS je to pak problém, do databáze se totiž znovu aktivují i všechny staré věci, takže jsou tam pak ty tisíce předaných článků uloženy tak nějak jednou provždy.
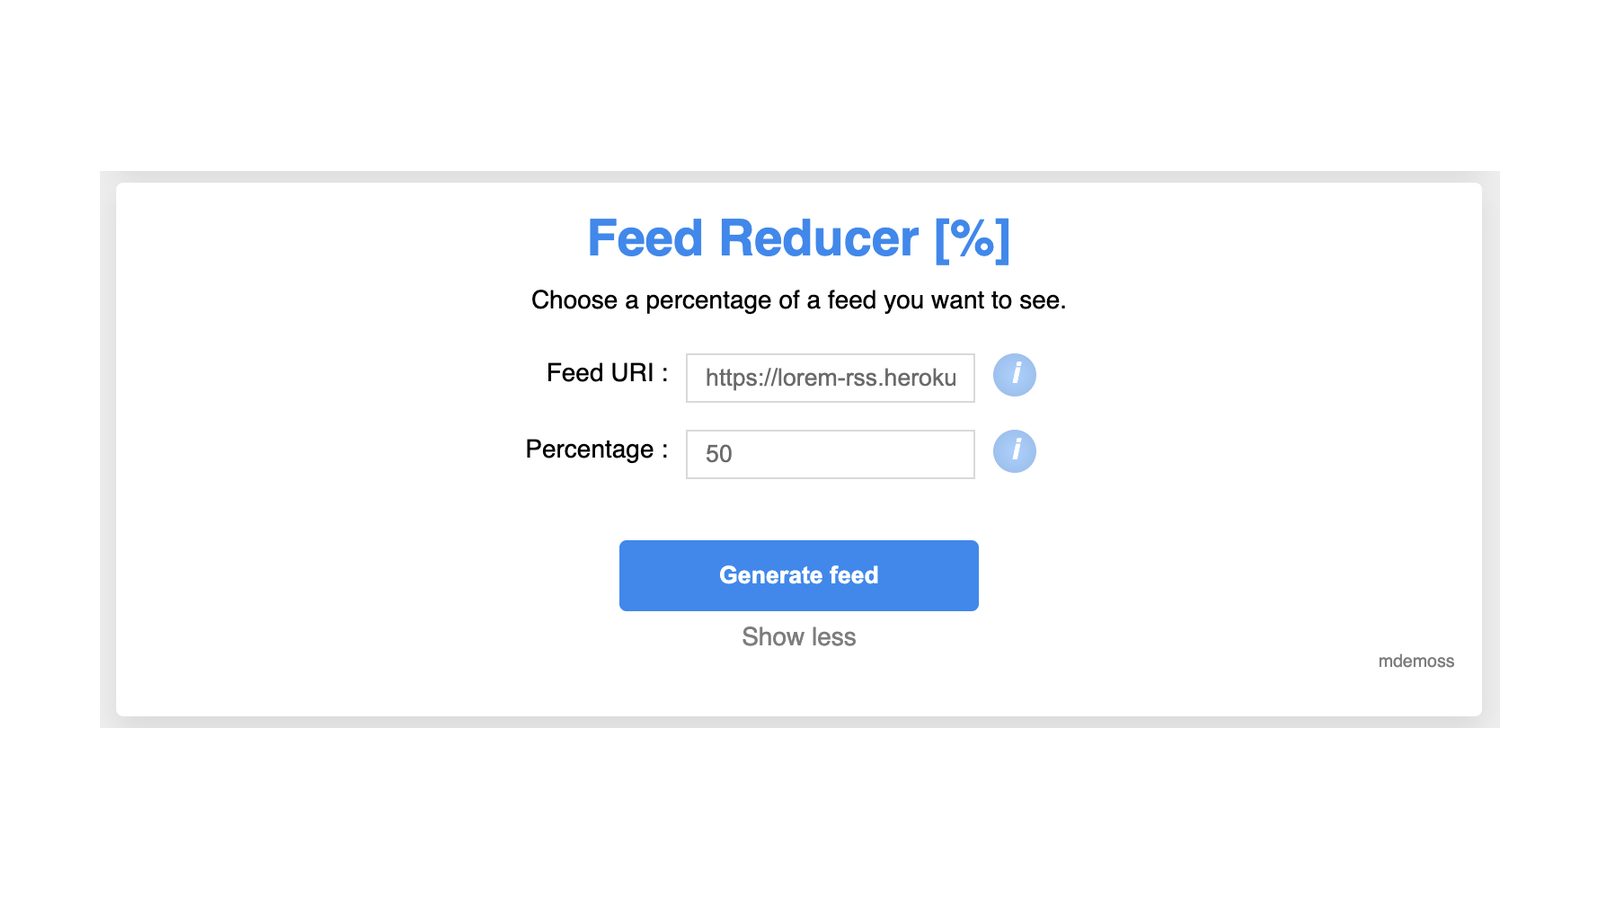
Existuje ale jedno řešení, poměrně jednoduché. Musíte ale mít RSS Bridge – ten se nejčastěji používá pro načítání webů, co nemají RSS, ale přesto je chcete mít ve čtečce. Jeden z “filtrů” v něm je Feed Reducer – zadáte tam adresu XML, co je moc velké, a řeknete, kolik % z něj chcete vrátit.
Do FreshRSS pak dáte feed vytvářený Reducerem – osobně jsem zvolil Atom variantu, ale možností je tam víc. Po filtraci prostě z původních tisíců položek můžete mít desítky – a protože se to stejně bude pravidelně načítat, tak nic nového neunikne.
Hodil by se filtr na počet položek místo procent, ale ten tam není. Byť, nutno dodat, nebyl by problém si ho doprogramovat. Nebo vzít Feed Reducer a forknout si ho do vlastní verze s doplněním počtu k vrácení.
Varianta pak navíc je, že si to prostě celé naprogramujete sami, protože jestli už hostujete FreshRSS a RSS Bridge, tak určitě můžete mít nějaké to PHP, co se postará o “filtraci”. V době, kdy vám to snadno napíše něco jako Codex/Claude Code/Cursor, to je navíc otázka jen napsání korektního zadání.
Výše zmíněné mé RSS už běží docela dlouho a dobře, viz Vlastní RSS agregátor i čtečka? Snadné s FreshRSS. Třeba na Raspberry Pi či jinde, kde můžete mít Docker a navíc slouží i jako zdroj článků pro další zpracování. Pro Kolotipy, Ecoista.cz i pro #TYDEN. Bere si je odtamtud trojice AI agentů, co každé ráno “chytře” vybírá témata. Ale o tom až někdy jindy.