Pozor, OpenAI týden před vánoci pustila do světa GPT Image 1.5. Tento tip vznikl pro verzi 1.0, takže některé věci budou platit, některé už ne. Pouštím ho ven, aby bylo možné odchytat změny a doplnit je. Chvíli bude trvat, než se vše ověří a objeví.
Měli byste vědět:
- Do GPT4o obrázky generovalo DALL E 3. Dnes už je dostupné jenom jako samostatný model
- Od GP4o je generuje “GPT Image” (přesně GPT-Image-1) nebo taky prostě “Image Generator”, tedy od března 2025. Popisované v ChatGPT má nový generátor fotek a obrázků (4o Image Generation). Je hodně jiný než DALL E 3. Jak na něj?
- Ten samý “GPT Image” je v 4o až do GPT 5.2
- Od 19. prosince 2025 je venku nové GPT Image, verze 1.5 a původní (1.0) verze už je jen jako CustomGPT. Viz Co je nového v GPT-Image 1.5? Tedy v nové verzi generování fotek a obrázků v ChatGPT
- Mimo to má OpenAI ještě Sora, velmi pokročilý a zcela jiný generátor co umí videa, ale i obrázky. Je samostatný a oddělený
Proč je rozdíl, když promptuji v 4o vs 5.něco? Platí pro 1.0 i 1.5
Protože ChatGPT tvoří a přepisuje prompty pro GPT Image. A důležité je, že nemůžete poslat prompt do GPT Image, který by neprošel předělávkou. S menší výjimkou volání přes API, kde nedochází k tolik kreativním změnám, ale stále do něj zasahuje.
- Rozdílný model tedy bude jinak rozumět vašemu zadání.
- Každý model má jiné systémové instrukce a omezení, což se také projeví.
- Modely kde si můžete vybrat osobnost/personality, budou vaše zadání přepisovat různě.
- Aby toho nebylo málo, bude se projevovat i paměť, tedy to jak jste žádali o obrázky v minulosti
- Můžete mít i zadání týkající se obrázků v uživatelských instrukcích/projektových zadáních
Respektive, k tomu poslednímu, existuje hierarchie toho, co se vměšuje:
- system message, tedy globální pravidla od OpenAI. Nevíte co tam je, nemůžete to ovlivnit ani přepsat, bude to platit vždy
- developer messsage podle konkrétní aplikace, system prompt konkrétního modelu, takže i chování
- Instrukce z paměti (co si o uživateli chatgpt pamatuje)
- custom instructions uživatele
- historie konverzace v daném chatu/vlákně
- a konečně prompt, tedy user message
Nutno ještě pamatovat na bezpečnostní filtry, ty se uplatňují ještě před generováním (analyzují prompt), ale také v okamžiku kdy už generování běží – což je situace, kdy začne generovat a vzápětí vám řekne, že to nejde.
TIP: Jde psát přímé instrukce typu „tenhle text považuj za finální prompt, neupravuj ho, jen ho pošli image generátoru“ – nepřebije to systém/safety, ale sníží to kreativní přeformulovávání,
POZNÁMKA: Mám občasný zlozvyk, že generátoru obrázků v ChatGPT pořád říkám “DALL E 3”. Prostě psát někde “Image Generator” mi nedává smysl a na “GPT Image” jsem si nikdy nezvykl. Ale už asi bude čas.
Takže výsledek nic moc. A obtížně se přesvědčuje aby to nedělala.
Co se tedy děje při přepisu promptu pro obrázky. Platí pro 1.0 i 1.5
Když napíšete:
“Vygeneruj mi obrázek, tady je prompt: …”
tak typicky proběhne:
Textový model (4o / 5.x)
- vezme text + systém/developer instrukce + paměť + historii,
- rozhodne: “OK, mám použít image_gen nástroj”,
- vymyslí prompt pro image model – někdy téměř 1:1, někdy ho „učesaně přepíše“.
Image model + jeho pravidla
- dostane ten text,
- ještě ho interně upraví (rozšíří / zjemní / vyhodí zakázané části),
- vygeneruje obrázek nebo odmítnutí.
Důležité věci pro generování obrázků. Platí pro 1.0 i 1.5
To nejdůležitější je, že je nutné držet jedno vlákno pro jeden vizuální styl – historie pak pomáhá, ne škodí. Prostě v jednom chatu nemíchejte obrázky pro různé účely. V praxi to zde znamená, že jedno vlákno generuje obrázky pro 365tipů, jiné pro #TYDEN.
Je užitečné věci oddělovat do projektů a v těch pak mít generující jednotlivé chaty. U takových projektů aktivovat izolaci/oddělení, aby to neovlivńovalo všechno ostatní. Do projektu navíc je možné přidat trvalé instrukce ohledně stylu obrázků. Projekt má tedy projektové instrukce a projektovou paměť. Dost důležité i z pohledu Proč oddělit pracovní a soukromou AI
Můžete využívat i dočasný/temporary chat (ale v GPTImage 1.5 to přestalo být možné, uvidíme jestli to ještě nezmění), to bude mít výhodu že neovlivní nic do budoucna. Je dobře využitelný tak, že máte kompletní zadání pro styl, které doplníte konkrétním požadavkem na obsah. V takovém chatu se samozřejmě uplatní systémové instrukce, nastavení konkrétní GPT a uživatelé Custom instructions. Neuplatní se paměť, historie chatu. A také se nic nebude ukládat do paměti. A samozřejmě se vám ani neuloží mezi chaty.
Častá chyba je nasypat všechno do jednoho promptu. Pokud chcete něco složitějšího, tak se vyplatí iterovat. Tj nejprve vytvořit jednoduchý prompt pro hlavní téma, formát. A pak instruovat jaké změny má udělat. Model mnohem líp chápe relativní úpravy než dlouhý seznam podmínek v prvním zadání.
- „same composition, but darker background“
- „same phone, but show only one app icon grid, no notifications“
- „make the ethernet cables more colorful and more in the foreground“
“GPT Image 1.0” neuměla dobře psát texty, ale zato měla velkou oblibu je tam dávat, takže bylo nutné to omezovat. Byla ale hodně tvrdohlavá a stejně je tam občas nacpala.
- „no text, no numbers, no logos, no watermarks“
- „no UI with real app names or brand names“
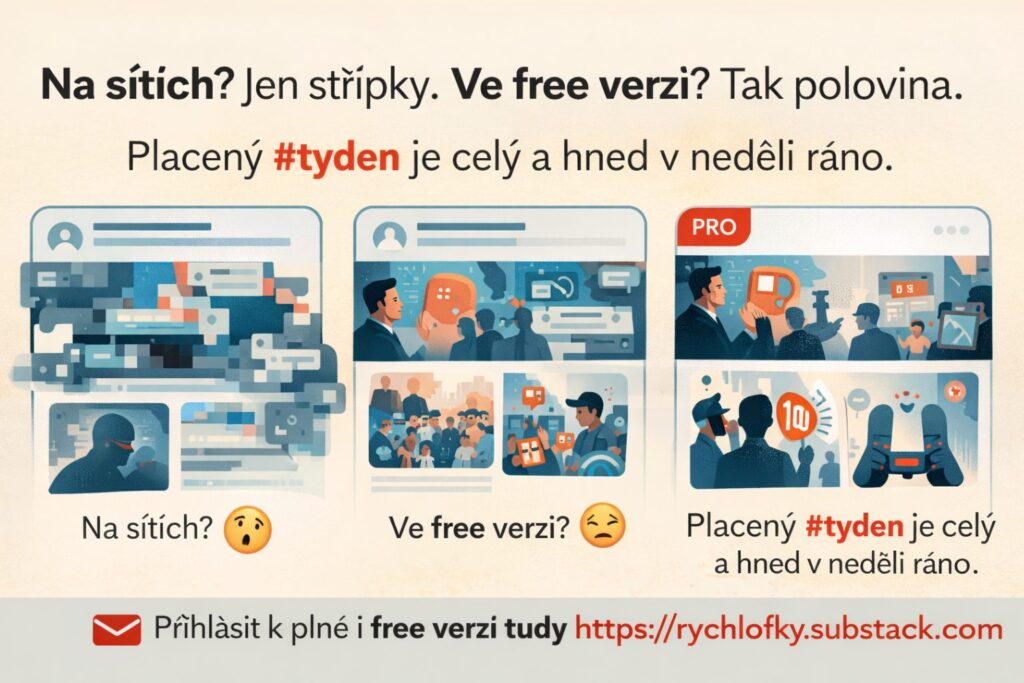
GPT Image 1.5 generuje texty nesrovnatelně lepší, ale stále může mít problémy s nabodeníčky. Všimněte si níže „neděli“, „sítích“, „střípky“ (prostě „ě“ či „ř“ je tam pakovaně s problémy).
Obrázky mají velkou spotřebu, budete zakládat další a další chaty. Platí pro 1.0 i 1.5
Obrázky spotřebovávají dost tokenů, takže po určité době se vlákno zaplňuje a jen nutné založit nové. Je tedy velmi důležité mít schované základní zadání (prompt) pro styl, abyste mohli začít znovu. Jak poznáte blížící se konec? ChatGPT chybuje, negeneruje obrázky, vytváří nesmysly, může se dokonce i kompletně seknout.
Chcete-li založit nové vlákno, můžete požádat i o to stávají o styl například takto:
„Prosím shrň náš dosavadní styl generování obrázků z tohohle vlákna do jednoho přehledného bloku, který si můžu uložit do Custom Instructions / nového vlákna.
Chci:
* stručný název stylu,
* jak vypadá (tone, barvy, detaily),
* kompozici (poměr stran, jak pracuješ s negativním prostorem),
* omezení (bez textu, log, atd.),
* ukázkový univerzální „style blok“, který budu jen doplňovat o téma.
Výstup dej prosím jako jeden kompaktní textové blok, připravené k vložení do Custom Instructions.“
Případně, kratší varianta.Kde tu poslední řádku můžete vypustit, pokud vás nebaví šablony pro vyplňování:
„Prosím vytvoř z tohoto vlákna přesnou definici stylu, kterou můžu vložit do nového chatu jako instrukci.
Výstup:
* stručný název stylu
* 5 až 10 bodů ‚takto vypadá výstup‘
* 1 univerzální stylový prompt pro generování obrázků, kde budu jen měnit téma.“
Pak založíte nový chat a začnete zhruba takto:
„Tohle vlákno bude sloužit jen pro [XY] (např. ilustrace pro 365tipů).
Používej prosím tenhle styl:
[SEM VLOŽIT TEN STYLE BLOK]
Při generování obrázků vždycky:
* drž se tohohle stylu,
* pokud zadání není jasné, raději se zeptej
* když navrhneš jinou variantu, dej ji až po té, která přesně splňuje styl.“
POZNÁMKA: To výše uvedené je použitelné třeba i pro textové styly pro psaní titulků, článků, popisků, příspěvků na sociální sítě. Jen tam samozřejmě místo “ilustrace” použijte odpovídající definici.
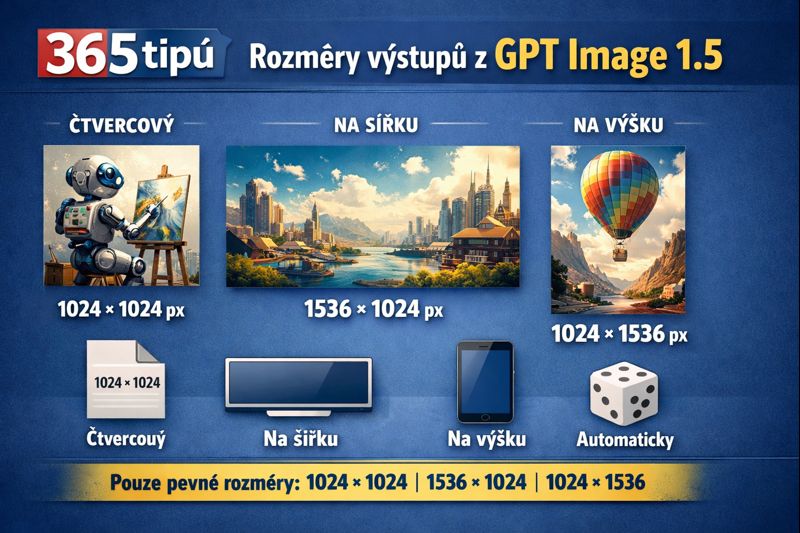
Jen tu češtinu to pořád 100% správně neumí.
Jak je to s rozměry a počty obrázků (a jménem)
Musíte si říkat o to jaký poměr stran chcete, GPT 1.0 tvrdohlavě tvořila 1:1 (čtverec) a to dokonce občas i když máte v zadání že chcete obdélník. Jak to bude v 1.5 uvidíme. Obrázky mají stále jen tři možné rozměry:
- 1:1 (čtverec, default) = 1024 x 1024 vs. 800 x 800 při stažení z chatu
- 16:9 (širokoúhlý landscape) = 1536 × 1024 vs. 800 x 533 při stažení z chatu
- 9:16 (vertikál na mobil) = 1024 × 1536 vs. 800 x 1200 při stažení z chatu
POZOR: V GPT Image 1.5 jde stáhnout plná podoba jenom po otevření obrázku „pro editaci“ a Save vpravo nahoře. Nelze pomocí Download vlevo dole na obrázku v chatu.
Teoreticky umí i jiné poměry (tedy že jim rozumí a ví co chcete), ale těžko říct co vám vlastně dodá, protože výsledek je stále jenom ten jeden ze tří základních rozměrů.
- landscape: 4:3, 3:2, 21:9
- portrét: 3:4, 2:3
DALL E 3 mimochodem měla místo 1536 o kousek větší 1792. A stejně jako GPT Image umí prostě jenom výše uvedené tři pixelové varianty.
Jméno vygenerovaného obrázku ovlivnit nejde (ač občas někdo tvrdí opak). Aktuálně (konec roku 2025) vypadají jména takto:
- ChatGPT Image Nov 14, 2025, 08_34_27 AM.png
Dřívější podoba, kdy jméno obsahovalo i velkou část promptu, už nefunguje.
Výstup je vždy PNG, nemůžete si říct o něco jiného.
Většinou vám vytvoří jeden obrázek, ale můžete narazit na to, že vám začne tvořit víc. Což můžete vyvolat promptem, například:
- „Vygeneruj několik variant“ / „dej mi 4 možnosti“ / „zkus víc verzí“
Háček je, že model může v jednom kroku vygenerovat víc obrázků, nebo je vygenerovat postupně (v rámci chatu).
S ohledem na to že generování trvá opravdu dlouho, tak může být praktické prostě přesně žádat:
- „Vygeneruj pouze jeden obrázek v tomhle stylu.“
- „Prosím jen jednu jedinou variantu obrázku, žádné další verze.“
Co se hodí pro tvorbu promptu
ChatGPT + GPT Image 1.0 je poněkud jednoduchá, takže komplexní zadání jsou problém. Chce to prostě jeden obrázek = jedna hlavní myšlenka. Jak to bude v GPT Image 1.5 ještě uvidíme, ale první zkušenosti říkají, že má mnohem více inteligence a je schopnější. Ale také svéhlavější.
Stále platí, že prompt v angličtině pochopí lépe, než v češtině (u Midjourney rovněž).
Když vám něco odmítá vytvořit, tak se především zeptejte proč a pokud tvrdí, že to odporuje pravidlům, tak můžete použít
- „udělej to tedy tak, aby to vyhovovalo pravidlům“
Hodí se pevná struktura promptu, ale je dost jisté, že tohle se vám nebude chtít dělat (vyplňovat)
SUBJECT (co je tam):
„a single black iPhone on a desk, screen visible, showing Instagram Reels feed“
CONTEXT (kde / co kolem):
„soft blurred background, hints of a laptop and coffee cup“
STYLE (jak to má vypadat):
„editorial digital illustration, semi-realistic, detailed textures, soft shadows, subtle gradients, modern tech magazine look“
COMPOSITION (jak to má být rozmístěné):
„16:9 landscape, main subject centered, lots of negative space around, room for text above if needed“
CONSTRAINTS (co nesmí):
„no text, no logos, no watermarks, no UI with real brand names“
Model vždycky něco odignoruje, když je toho moc. Pomáhá naznačit, co je nesmlouvavé. Tedy například:
- „must be 16:9 landscape“
- „must show only one phone, not multiple“
- „strictly no text, no numbers, no logos“
TIP: S ChatGPT si můžete o generování obrázků povídat a žádat o pomoc, vysvětlení. Stejně tak umí dobře generovat prompty pro Midjourney a další generátory. Ale to už je v tipu ChatGPT umí generovat prompty pro jiné obrázkové či video generátory
Lépe zvládá i ohniskový bod a negativní prostor
- „clear focal point“
- „clean background“ / „simple gradient background“
- „lots of negative space around the main subject“
Modely dobře reagují na „foto/film“ slovník:
- „close-up“ = detail (např. microSD kartu přes půl obrázku).
- „medium shot“ = postava po pás (dobré na lidi v editorialu).
- „wide shot“ = celá scéna/architektura.
- „isometric view“ = hodně užitečné u tech věcí, kabelů, konektorů, schémat.
Daleko více lze uplatňovat „čím to bylo foceno“ a podobné vychytávky známé spíš ze Stable Diffusion či Midjourney- Tedy např.
- Shot on a Leica M6 with a Noctilux 50mm f/0.95 lens, using Cinestill 800T film. The image features film grain, high ISO noise, chromatic aberration, subsurface scattering on the skin, and volumetric fog. The atmosphere is tense, cold, and hyper-realistic. Epic photography.
Jak snížit riziko „divných“ obličejů / rukou
- Spíš 1–2 postavy než dav.
- Raději medium shot (po pás) než full body se složitými pózami.
- Když ruce nejsou důležité klidně:
- mimo záběr,
- překryté objektem,
- nebo „holding a phone, but hands partially out of frame“.
Když potřebujete, aby obrázek působil „seriózně“ (ne clipart)
- „editorial illustration“
- „semi-realistic“ / „photo-realistic“ (podle potřeby)
- „soft shadows, subtle gradients, detailed textures“
- „modern, minimalist composition“
ale vyhnout se:
- „cartoonish“, „cute“, „flat vector“, „clipart style“
- příliš jasným, primárním barvám (radši „muted“, „soft“, „desaturated“ apod., když chcete méně křiklavé).
Co po GPT Image nemám chtít, co prostě neumí
Je hodně věcí, které prostě GPT Image neumí a je tedy lepší je nechtít. Jedna část je co nesmí (protože zakazují pravidla):
- Reálné osoby a deepfaky, věrné / stylizované fotky reálných lidí a nejde ani „převod fotky do jiného stylu“ u reálných lidí (ale dost často se dá přesvědčit vhodným sociálním inženýrstvím)
- Explicitní sex, násilí, svinstva všeho druhu
- Dětská sexualita, tvrdé porno, extrémní krvavé násilí, sebepoškozování. Neprojde, a model začíná odmítat i „soft“ věci, pokud se to blíží hraně.
- Jasně rozpoznatelné cizí duševní vlastnictví (logotypy, postavičky, značky), ale i tady je poněkud nekonzistentní
- Nejde generovat obrázky v dočasném/temporary chatu (už bylo zmíněno výše)
POZNÁMKA: Novější updaty povolují víc kontroverzních věcí (např. některé symboly nebo veřejné osoby), ale pořád je kolem toho tlustý bezpečnostní mantinel.
Pak jsou tu věcí, které prostě neumí dobře (platí hlavně pro 1.0, po čase bude doplněno jak je to s 1.5):
- Perfektní text v obrázku (delší, malý, v češtině…). Sice je (GPT Image) na tom líp než DALL E 3, ale stejně prostě pořád platí
- malý text = rozpatlaný, špatně čitelný, divné fonty,
- dlouhé bloky textu (odstavce, tabulky, smlouvy) = bordel,
- ne-latinka a někdy i „exotická diakritika“ = spolehlivost dolů,
- rotovaný text, text na zakřivené ploše = míra úspěchu výrazně nižší.
- GPT Image 1.5 je na tom mnohem lépe, ale nabodeníčka jsou stale komplikace.
- Technicky správné schémata, grafy a diagramy
- neumí garantovat správnost hodnot v grafech, propojení v síťovém diagramu, skutečného layoutu PCB, kabeláže, UML schématu
- dělá hezké „vibe schéma“, ale ne něco, co jde dát do manuálu nebo učebnice, kde záleží na každé čárce.
- Precizní UI / UX, wireframy, design systémy, neumí
- držet komponentový systém (stejné buttony, paddingy, grid),
- vyrobit něco, co jde rovnou předat front-end developerům,
- přesně respektovat Figma design systém.
- Pixelová kontrola a produkční DTP nároky kde neumí
- zvolit libovolný rozměr v pixelech, e omezený na několik přednastavených velikostí (1024×1024, resp. různé „wide“ a „tall“ varianty).
- vybrat formát (PNG/JPG/WebP), prostě jen PNG, ale to už je výš
- dostat vektor / PSD / vrstvy, vždycky jen plochý raster.
- ovlivnit barevný profil (sRGB vs CMYK pro tisk), na seriózní DTP je nutný ruční postprocessing.
- Konzistentní „postavy“ napříč sérií obrázků. GPT Image umí hezky jednu scénu, ale
- u série 5–10 obrázků se postava, oblečení, obličej i pozadí mezi generacemi dost mění,
- nejde mu říct: „přesně tahle postava jako v předchozím obrázku, jen teď z boku“, částečně to lze obejít promptováním a edity, ale není to stabilní.
- Infografiky a „datové plakáty“. GPT Image umí nakreslit něco, co vypadá jako infografika – barevné bloky, pseudo-grafy, ikonky. Ale neumí
- udržet správná čísla (často je vymyslí nebo pomíchá),
- zachovat strukturu (osy, legendy, popisky se přehazují nebo mizí),
- vykreslit text čitelně a bez chyb (hlavně u delších popisů a menších fontů),
- zajistit, aby obrázek byl opravdu „ready to publish“ jako datový zdroj.
- V 1.5 se to opět dost změnilo k lepšímu, ale uvidíme.
- Fyzikálně / fakticky korektní scény, kde zejména neumí
- světlo, stíny, perspektiva občas nesedí,
- detaily techniky, konektory, porty, tlačítka, text na displeji mohou být vymyšlené nebo nesmyslné
- Medicínské snímky a diagnostika
POZNÁMKA: Ofiko dokumentace OpenAI uvádí, že GPT image není vhodný pro interpretaci specializovaných medicínských snímků (CT, RTG, MRI apod.) a neměl by se používat pro diagnózy.
Grafické výstupy co netvoří GPT Image
Po ChatGPT můžete chtít grafy, SVG, ASCII diagramy, ale i tady jsou různé komplikace. Při zadání „vygeneruj mi SVG graf“ umí leccos, ale výsledky mohou být zmatené.
Můžete chtít „udělej mi graf“ a dostanete (například) PNG z kódu (Python) nebo Mathplotlib. Ale i tady platí, že se to často prostě nepovede.
Proč se to nepovede? No, důvodů je dostatek:
- Model „nevidí“, co kreslí – generuje SVG jako text, znak po znaku. Nemá živý náhled, neudělá krok typu „vykreslil jsem to, vypadá to blbě, opravím to“. Prostě vymyslí kód, odešle, hotovo.
- Nemá v hlavě skutečný layout – SVG je o přesných souřadnicích, zarovnání, tloušťkách čar, font-size. Pro model je to jen spousta čísel a atributů v textu. Stačí pár odchylek a graf je najednou nečitelný, přelepený nebo mimo plátno.
- S daty zachází „přibližně“ – Pro AI je přirozené „vymyslet si rozumně vypadající čísla“, ne je striktně spočítat a převést na přesné pozice bodů v grafu. U jednoduchého příkladu to projde, u reálných datových vizualizací to končí nepoužitelným paskvilem.
- Dlouhý a složitý kód = větší šance na chybu – Čím víc prvků (osy, grid, legendy, popisky, více sérií dat), tím větší šance, že model někde zapomene uzavřít tag, rozhodí pořadí prvků nebo prostě něco ustřihne.
Jak to s grafy a SVG brát realisticky
- Nečekejte hotovou věc na první dobrou – AI je skvělá na koncept, rychlý návrh, jak by graf mohl vypadat. Ne na finální SVG, které bez zásahu člověka poletí rovnou do reportu nebo na web.
- Nechte AI napsat kód pro nástroj, ne přímo umělecké SVG – Mnohem spolehlivější je nechat si vygenerovat kód pro matplotlib / Vega-Lite / Chart.js a z toho udělat graf. Tam už existuje „skutečný“ renderer, který drží proporce, měřítka i data.
- Když SVG, tak spíš skeleton než katedrálu – Smysl má nechat si vygenerovat jednoduchý základ (osy, pár čar, základní layout) a ten si pak ručně doladit. Čím složitější zadání, tím větší pravděpodobnost, že z toho bude polámanej cirkus.
- AI grafy jsou dobré na obrázek, ne na audit – Pokud jde o datovou přesnost (report, prezentace pro management, analytika), berte AI jako pomocníka na návrh vzhledu, ne jako zdroj „officiálního grafu“.
Další tipy týkající se AI (ChatGPT a další)